# SQL-101
SQL ကိုလေ့လာချင်တဲ့ beginners တွေအတွက်ရည်ရွယ်ပြီး သင့်တော်မယ့်ကောင်းနိုးရာရာအပိုင်းတွေကိုထုတ်နုတ်ပြီး series လေးလုပ်ထားလိုက်တာဖြစ်ပါတယ်။
Series ထဲမှာမပါနိုင်တဲ့တစ်ခြားသောအကြောင်းအရာတွေများစွာရှိသေးအတွက် ဒီနေရာကနေလမ်းစတစ်ခုရပြီး ရှေ့ဆက်လေ့လာသွားဖို့အထောက်အကူပြုနိုင်မယ်လို့မျှော်လင့်ပါတယ်။
လိုအပ်တာတွေရှိရင်လည်း issues & pull request လုပ်ပြီးဝင်ရောက်ဖြည့်စွက်ပေးနိုင်ပါတယ်ခင်ဗျာ။
အထောက်အကူပြုတယ်ဆို Repo မှာ star ဝင်ပေးသွားနိုင်ပါတယ်ခင်ဗျာ။
Gitbook ကနေတစ်ဆင့်လွယ်လင့်တကူဖတ်ရှုနိုင်ပါတယ်။\
Web development နဲ့ပတ်သတ်တဲ့ playlists, videos များကိုလည်း Youtube မှာဝင်ရောက်ကြည့်ရှုနိုင်ပါတယ်။\
ကျေးဇူးတင်ပါတယ်ခင်ဗျာ။
# Data & Database
SQL 101 series ရဲ့ပထမဦးဆုံးအပိုင်းဖြစ်ပါတယ်။
ဒီအပိုင်းမှာတော့ data နဲ့ database အကြောင်းကို intro ဝင်ပေးသွားပါမယ်။
ဒေတာ(data) ဆိုတဲ့ စကားလုံးကိုကျနော်တို့အားလုံးမစိမ်းလောက်ပါဘူး။ ကျနော့်တို့ကိုယ်တိုင်ကစလို့ နေရာတိုင်းမှာ data တွေရှိတယ်။ ဘယ်လိုအရာတွေကို data လို့ခေါ်နိုင်လဲဆိုရင် အချက်အလက်တစ်ခုက ကောက်ယူလို့ရမယ်၊ သိမ်းဆည်းလို့ရမယ်၊ အသုံးပြုလို့ရမယ်ဆိုရင် data လို့သတ်မှတ်နိုင်ပါတယ်။ ဥပမာဖုန်းထဲကဓါတ်ပုံ၊ဗီဒီယိုတွေ၊ ရာသီဥတုအချက်အလက်တွေ၊ စတော့ဈေးနှုန်းတွေစသည်ဖြင့် ဒါတွေအားလုံးက data တွေပဲဖြစ်ပါတယ်။ ယနေ့ခေတ်မှာ data တွေက အလွန်တန်ဖိုးရှိလာပါတယ်။ ဒါကြောင့်လည်း data တွေအများကြီးပိုင်ဆိုင်ထားတဲ့ google, facebook တို့လို companies တွေဟာတန်ဖိုးကြီးနေရခြင်းဖြစ်ပါတယ်။
နေ့စဉ်နဲ့အမျှနေရာပေါင်းစုံကနေ data တွေထွက်နေနိုင်ပါတယ်။ သို့ပေမယ့် ဒီ data တွေကိုသိမ်းဆည်းခြင်းမရှိဘူးဆိုရင် ပြန်လည်အသုံးပြုလို့မရနိုင်တဲ့အတွက် အကျိုးမရှိနိုင်ပါဘူး။ သိမ်းဆည်းဖို့နည်းလမ်းတစ်ခုလိုအပ်တဲ့အတွက် database ဆိုတဲ့အရာကို အသုံးပြုပါတယ်။ database ထဲမှာ data တွေသိမ်းဆည်းခြင်း၊ ပြန်လည်ထုတ်ယူသုံးစွဲခြင်းစသည်ဖြင့်ပြုလုပ်ကြပါတယ်။
Database ဆိုလို့အသစ်အဆန်းတစ်ခုတော့မဟုတ်ဘူး၊ computer တစ်လုံးသက်သက်ပါပဲ။ hardware နဲ့ software ပေါင်းစပ်ပြီး data တွေသိမ်းဆည်းတာတွေ၊ အသုံးပြုတာတွေပြုလုပ်နိုင်ပါတယ်။ နောက်လာမယ့်အပိုင်းတွေမှာ computer ထဲကို လိုအပ်တဲ့ software installation လုပ်ပြီးတော့ စတင်လေ့လာကြပါမယ်။
# DBMS
သိမ်းဆည်းထားတဲ့ data တွေကို manage လုပ်ဖို့အတွက်ဆိုရင် DBMS ဆိုတဲ့အရာတွေကလိုအပ်လာပါတယ်။
DBMS အကြောင်းကိုရေးရင်းနဲ့တစ်လက်စတည်း database models အကြောင်းနဲ့ RDBMS အကြောင်းကိုရေးပေးသွားပါမယ်။
DBMS ဆိုတာက software တစ်ခုပါပဲ။ အဲ့ဒီ software ကိုအသုံးပြုပြီးတော့ database ထဲမှာရှိတဲ့ data တွေကို ထုတ်ယူ၊သိမ်းဆည်း၊ပြုပြင်တာတွေကိုလုပ်ဆောင်နိုင်ပါတယ်။ ပြောရမယ်ဆိုရင် အသုံးပြုသူနဲ့ database နှစ်ခုကြားထဲမှာ data တွေကို manipulate လုပ်ဖို့ interface တစ်ခုအနေနဲ့တည်ရှိနေပါတယ်။ User -> DBMS -> Database ပုံစံမျိုးပေါ့။ အသုံးပြုသူကနေတစ်ဆင့် လိုသလို data တွေကို manage လုပ်နိုင်ဖို့အတွက် DMBS ကို inputs (queries) တွေပေးဖို့လိုပါသေးတယ်။ ဒီအပိုင်းကိုတော့နောက်အပိုင်းတွေမှာထပ်ရေးသွားပါမယ်။
DBMS တွေကအမျိုးမျိုးရှိတယ်၊ ရွေးချယ်ထားတဲ့ database models ပေါ်မူတည်ပြီးတော့ DBMS ပုံစံတွေကလည်းကွဲပြားတယ်။ Database model ဆိုတာကတော့ database system တစ်ခုမှာ data တွေကိုဘယ်လို structure တွေနဲ့သိမ်းဆည်းမယ်၊ ချိတ်ဆက်မယ်ဆိုတာတွေကိုသတ်မှတ်ထားတဲ့ ပုံစံဖြစ်ပါတယ်။ ဥပမာ Model A ဆိုရင် Excel ထဲမှာ rows တွေ column တွေနဲ့မှတ်ပြီးသိမ်းမယ်၊ Model B ဆိုရင် Notepad ထဲမှာပဲ key value pair ပုံစံတွေနဲ့သိမ်းမယ် စသည်ဖြင့် model ပေါ်မူတည်ပြီး data တွေကိုစီမံခန့်ခွဲပုံကလည်း ကွဲပြောင်းသွားပါတယ်။ Database Models တွေအများကြီးထဲကမှအသုံးများတဲ့ models တွေကို list down လုပ်ပေးထားလိုက်ပါမယ်။
* Relational Model
* Hierarchical Model
* Network Model
* Object-Oriented Model
* Document Model
* Graph Model စသည်ဖြင့်ရှိကြပါတယ်။ DB Engines ranking ဆိုပြီးရိုက်ရှာကြည့်လိုက်မယ်ဆိုရင်လည်းအသုံးများတဲ့ model တွေကိုတွေ့နိုင်ပါတယ်။
ဒီ article series မှာကတော့ Structure Query Language (SQL) ကိုအသုံးပြုတဲ့ Relational Model အကြောင်းကိုပဲလေ့လာသွားကြပါမယ်။ Relational model ကိုအသုံးပြုတဲ့ RDBMS မှာလည်း provider ပေါ်မူတည်ပြီးတော့ DBMS software တွေကအနည်းနဲ့အများကွဲပြားသွားနိုင်ပါသေးတယ်။ သို့ပေမယ့် SQL oriented approach နဲ့သွားတာဖြစ်တဲ့အတွက်အများကြီးပြောင်းလဲသွားတာတော့မရှိပါဘူး။ ဥပမာ
* Oracle Database
* MySQL
* PostgreSQL
* Microsoft SQL Server စသည်ဖြင့်ပေါ့။ အားလုံးက RDBMS ဖြစ်ပေမယ့် company ပေါ်မူတည်ပြီးအသုံးပြုပုံအနည်းငယ်ကွာဟသွားနိုင်ပါတယ်။
Relational Model တွေက data တွေကိုဘယ်လိုသိမ်းဆည်းလဲဆိုတာနဲ့ပြန်ဆက်ရအောင်။
သူတို့က data တွေကို table ပုံစံ၊ row , column နှစ်ခုပါတဲ့ two dimensional structures နဲ့သိမ်းဆည်းပါတယ်။ table တစ်လုံးခြင်းဆီတိုင်းမှာ rows (records) , columns (fields) ပုံစံတွေနဲ့သက်ဆိုင်ရာ data တွေကိုထည့်သွင်းသိမ်းဆည်းပါတယ်။ row (record) တစ်ခုခြင်းဆီတိုင်းကို unique ဖြစ်စေဖို့ (row အချင်းချင်း duplicate/conflict) မဖြစ်စေရန် primary key သတ်မှတ်ပေးပြီးတော့ table တစ်လုံးက field တစ်ခုကနေပြီးတော့ နောက် table တစ်လုံးက primary key ကိုလှမ်း reference လုပ်ချင်တဲ့အချိန်မှာ foreign key အဖြစ်သတ်မှတ်တာမျိုးတွေလည်းရှိပါတယ်။
လောလောဆယ်တော့နည်းနည်းရှုပ်နေနိုင်သေးပေမယ့် နောက်လာမယ့်အပိုင်းတွေမှာ query တွေရေးကြည့်တဲ့အခါလွယ်ကူသွားပါလိမ့်မယ်။
# Introduction to SQL
Relational Database တွေကိုစီမံခန့်ခွဲဖို့အတွက် SQL, Structure Query Language ဆိုတဲ့ programming language ကိုအသုံးပြုပါတယ်။ Database ထဲမှာရှိတဲ့ data တွေကို ထုတ်ယူ၊သိမ်းဆည်း၊ပြုပြင်၊ရှင်းလင်းတာတွေကိုလုပ်နိုင်ဖို့အတွက် DBMS ကိုအသုံးပြုပါတယ်။ DBMS ကို SQL commands တွေပေးလိုက်ခြင်းဖြင့်လိုသလို စီမံနိုင်သွားမှာဖြစ်ပါတယ်။ အရှေ့မှာတုန်းက DBMS ဆိုတာဟာ user နဲ့ database ကြားထဲက software တစ်ခုဆိုပြီးရေးသားခဲ့ပါတယ်။
ထိုနည်းလည်းကောင်းပဲ SQL ဆိုတာက DBMS နဲ့ user ကြားထဲကအရာတစ်ခုပါပဲ။ SQL ဆိုတာကလည်း commands လေးတွေပါပဲ။ ဥပမာ Student table ထဲကအသက်၂၀ကျော်တဲ့ data တွေကိုဆွဲထုတ်ပေးပါ။ Student table ထဲကအသက်၃၀ကျော်တဲ့ data တွေကိုဖျက်ပေးပါ၊ စသည်ဖြင့်။
အမှန်တစ်ကယ် SQL syntax ကဒီလိုတော့မဟုတ်ဘူးပေါ့။ နောက်ပိုင်းမှာပါလာပါမယ်။ User ကပြုလုပ်ချင်တဲ့ data စီမံခန့်ခွဲမှုတွေကို SQL အသွင်ပြောင်းလဲပြီးတော့ DBMS ကိုပေးလိုက်တယ်၊ DMBS ကနေတစ်ဆင့် data တွေကိုပြင်ဆင်ပြောင်းလဲမှုတွေလုပ်ဆောင်နိုင်ပါတယ်။
## What is a Query?
Relational Database ထဲက data တွေကိုစီမံခန့်ခွဲဖို့အတွက် DBMS ကိုပေးလိုက်တဲ့ commands တွေကို SQL လို့ခေါ်ပါတယ်။ Query တွေကိုအသုံးပြုပြီးတော့ data တွေကိုလိုအပ်သလို filter, sorting, calculation တွေလုပ်ပီး ဆွဲထုတ်နိုင်တဲ့အပြင် data အသစ်သိမ်းဆည်းခြင်း၊ ရှိပြီးသား data တွေကိုပြုပြင်ခြင်း၊ ဖယ်ရှားခြင်းတို့ကိုလည်းလုပ်ဆောင်နိုင်ပါတယ်။ Data ဆွဲထုတ်တဲ့နေရာမှာ Table တစ်လုံးထဲကနေလည်းဆွဲထုတ်တာလည်းရှိသလို တစ်ခုထက်ပိုတဲ့ Tables တွေကိုချိတ်ဆက်ပြီးတော့လည်းထုတ်နိုင်ပါတယ်။
## SQL Standards
DBMS software ပေါ်မူတည်ပြီးတော့ SQL Standard ကလည်းအနည်းငယ်ကွဲပြားသွားနိုင်တာကို ဒီနေရာမှာထည့်သွင်းရေးသားချင်ပါတယ်။ ဘာသာစကားတစ်ခုတောင်မှ နေရာဒေသပေါ်မူတည်ပြီး ခေါ်ဆိုပုံတွေ၊ လေယူလေသိမ်းတွေကွဲပြားသွားသလိုပဲ SQL မှာလည်း DBMS software ကိုလိုက်ပြီးတော့ syntax ရေးနည်း၊ရေးဟန်တွေအနည်းငယ်ကွဲပြားတာမျိုးရှိတတ်ပါတယ်။ SQL Dialect လို့လည်းခေါ်နိုင်ပါတယ်။ DBMS software ဆိုတာကတော့ company တွေကထုတ်တာတွေပေါ့ဗျာ။ ဥပမာ
* MySQL
* Oracle
* Microsoft SQL Server
* PostgreSQL စသည်ဖြင့်ပေါ့။
လက်တွေ့ဥပမာလေးတစ်ခုနဲ့ပြရရင် student table ထဲက hlaing ဆိုတဲ့နာမည်ရှိတဲ့ကျောင်းသားကိုဆွဲထုတ်ချင်တယ်ဆိုပါစို့ MySQL မှာဆိုရင်
```
SELECT * FROM students WHERE name = 'hlaing'
```
hlaing ဆိုတဲ့နာမည်ကို single quote ခံလည်းရသလို "hlaing" ဆိုပြီး double quote နဲ့လည်းဆွဲလို့ရပါတယ်။ သို့ပေမယ့် PostgreSQL မှာတော့ single quote ပဲအသုံးပြုနိုင်မယ်။ ဒါမျိုးအနည်းငယ်ကွဲပြားမှုလေးတွေရှိနိုင်ပါတယ်။ နောက်ပြီး function နာမည်အချို့ပေါ့၊ အလုပ်လုပ်ပုံတူပေမယ့် naming လေးတွေကွဲပြားနိုင်ပါတယ်။
## SQL Naming Conventions
Programming တစ်ခုခုရထားပြီးသားဆိုရင်တော့ naming conventions ကိုမစိမ်းလောက်ဘူးထင်ပါတယ်။ SQL မှာလည်း query တွေရေးတဲ့အချိန်သတ်မှတ်လိုက်တဲ့ naming words တွေနဲ့ပတ်သတ်ပြီးလိုက်နာသင့်တဲ့ scheme လေးတွေရှိပါတယ်။ နောက်ပိုင်း query ရေးရင်တော့ပိုသိလာမှာဆိုတော့ ဒီအပိုင်းမှာအကြမ်းဖျင်းပဲရေးလိုက်ပါမယ်။
* နားလည်ရလွယ်ကူမယ့် naming ပေးရန်။
* Reserve keyword တွေဖြစ်တဲ့ SELECT, INSERT, UPDATE စတဲ့ keyword တွေကိုရှောင်ရှားရန်။
* Naming ပေးတဲ့အခါ space နဲ့ special characters တွေကိုရှောင်ရှားရန်။
* လိုအပ်ပါက space အစား underscore သို့ Camel Case အသုံးပြုရန်။
* ကိုယ်သုံးတဲ့ casing ကို consistent ဖြစ်အောင်သုံးရန်။
* တစ်နေရာမှာ underscore, တစ်နေရာမှာ camel case, နောက်တစ်နေရာမှာ snake case ဆိုရင် readability ညံ့စေတဲ့အပြင် query ကိုရှုပ်ထွေးစေပါတယ်။
အရှေ့အပိုင်းမှာ Table, Row, Column ကို intro ဝင်ခဲ့ပါတယ်။ အခုထပ်ပီးရှင်းလင်းပေးသွားပါမယ်။
### Table
SQL မှာ data တွေသိမ်းဆည်းဖို့အတွက် table format ကိုအသုံးပြုပါတယ်။ Table တစ်ခုမှာ rows နဲ့ columns တွေပါဝင်ပါတယ်။ row တစ်ကြောင်းခြင်းဆီတိုင်းကို record တစ်ခုအဖြစ်သတ်မှတ်လို့ရနိုင်ပြီး column ဆိုတာကတော့ record ထဲမှာရှိတဲ့ data attribute/field ကိုဆိုလိုခြင်းဖြစ်ပါတယ်။ Table format နဲ့သိမ်းဆည်းခြင်းအားဖြင့် data တွေကိုစီမံရတာပိုမိုလွယ်ကူစေပါတယ်။ CREATE TABLE ဆိုတဲ့ SQL keyword ကိုအသုံးပြုပြီးတော့ Table တည်ဆောက်နိုင်ပါတယ်။
### Row
Row ဆိုတာ record ပါပဲ။ table တစ်ခုထဲမှာရှိတဲ့ rows တိုင်းဟာ record instance တစ်ခုခြင်းဆီအဖြစ်ကိုယ်စားပြုပါတယ်။ row တစ်ခုမှာလည်း column လို့ခေါ်တဲ့ သက်ဆိုင်ရာ attribute တွေပါဝင်ပါတယ်။ INSERT, UPDATE, DELETE ဆိုတဲ့ keyword တွေကိုအသုံးပြုပြီး row တွေကို သိမ်းဆည်း၊ ပြုပြင်၊ ဖယ်ရှားနိုင်ပါတယ်။
### Columns
Row ထဲမှာရှိတဲ့ attribute/field ဖြစ်ပါတယ်။ field တစ်ခုခြင်းဆီတိုင်းဟာသိမ်းဆည်းတဲ့ data ပေါ်မူတည်ပြီးတော့ data type တွေလည်းကွဲပြားနိုင်ပါတယ်။ ဥပမာနာမည်ဆို text, အသက်ဆို integer, ရက်ဆို date စသည်ဖြင့်။
#### Student Table
ID Name Age 1 John 18 2 Sarah 17 3 David 16 ဥပမာ Table တစ်ခုပါ။ 1,2,3 ဆိုတဲ့ row ၃ခုရှိပြီးတော့ row တစ်ခုခြင်းဆီတိုင်းမှာ ID, Name, Age ဆိုတဲ့ column တွေပါဝင်ပါတယ်။ row, column အားလုံးပါဝင်တဲ့ဒီတစ်ခုလုံးကိုတော့ table ဆိုပြီးခြုံငုံသတ်မှတ်နိုင်ပါတယ်။
# Data Types in SQL
ဒီအပိုင်းမှာတော့ SQL မှာရှိတဲ့ data types တွေအကြောင်းကိုဆွေးနွေးသွားပြီးတော့ နောက်အပိုင်းကနေစပြီးတော့ environment setup (လိုအပ်တဲ့ software တွေသွင်း) လုပ်မယ်၊ လက်တွေ့ query တွေရေးပြီးတော့ ဆက်လက်လေ့လာသွားကြပါမယ်။
အရှေ့မှာ SQL ရဲ့ table, row, column တွေအကြောင်းကိုအဓိပ္ပါယ်ဖွင့်ဆိုခဲ့ပါတယ်။ Column တစ်ခုမှာ data သိမ်းတော့မယ်ဆို သိမ်းချင်တဲ့ data ရဲ့ပုံစံကိုပါထည့်သွင်းဖော်ပြပေးရပါတယ်။ ဥပမာမြင်သာအောင်ပြောရရင် programmers ဆိုတဲ့ programmer တွေရဲ့ data ကိုသိမ်းမယ့် table တစ်ခုရှိတယ်ဆိုပါစို့။ name, email, gender, age ဆိုတဲ့ column လေးခုသိမ်းဆည်းကြပါမယ်။
* name ကို စာသား
* email ကိုလည်းစာသား
* gender ကိုလည်းစာသားသိမ်းမယ်၊ Male, Female
* ဒါမှမဟုတ် ကိန်းကဏန်းအနေနဲ့ 1,2 နဲ့သိမ်းလည်းရတာပဲ၊ 1 က male, 2 က female
* age ကိုတော့ ကိန်းကဏန်းအနေနဲ့သိမ်းမယ်။ 20, 30 စသည်ဖြင့်ပေါ့။
ဘာလို့ဒီလိုတွေခွဲပြီးသိမ်းနေရတာလဲ၊ တစ်မျိုးတည်းသတ်မှတ်ပြီးသိမ်းလည်းရတာပဲမဟုတ်လားလို့မေးစရာရှိပါတယ်။ ဘာကြောင့် data types တွေခွဲသိမ်းဖို့လိုတယ်၊ အရေးကြီးတယ်ဆိုတာကို ဒီ article conclude လုပ်တဲ့အချိန်မှာ ထည့်ရေးပေးသွားပါမယ်။
လောလောဆယ်ဘယ်လိုမျိုး data types တွေရှိတယ်ဆိုတာကြည့်ရအောင်။ ဒီ article မှာတော့ common data types အသုံးများတဲ့ data types တွေအကြောင်းကိုထည့်ပေးသွားပါမယ်။ data types တွေကအများကြီးရှိတဲ့အပြင် အရှေ့မှာပြောခဲ့တဲ့ DBMS software တွေပေါ်မူတည်ပြီးတော့လည်းအမျိုးမျိုးကွဲပြားနိုင်သေးတယ်။ သို့သော် အခုရေးထားတဲ့ data types တွေနားလည်ထားမယ်ဆို စတင်လေ့လာတဲ့သူတစ်ယောက်အနေနဲ့ လုံလောက်မယ်လို့ယူဆပါတယ်။
* Numeric data type - ကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* Character data type - စာသားတွေသိမ်းဆည်းရန်
* Date & Time data type - နေ့ရက်နှင့်အချိန်ကာလတွေသိမ်းဆည်းရန်
တစ်ခုခြင်းဆီကိုအသေးစိတ်ပြန်ကြည့်ရရင်
## Numeric Data Types
* TINYINT – 1-byte size ကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* SMALLINT – 2-byte size ကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* INT – 4-byte size ကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* BIGINT – 8-byte size ကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* DECIMAL – precise ဖြစ်တဲ့၊တိကျသေချာတဲ့ ဒဿမကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* FLOAT – approximate ဖြစ်တဲ့၊ မှန်းခြေ ဒဿမကိန်းကဏန်းတွေသိမ်းဆည်းရန်
* DOUBLE – FLOAT ထက်ပို precise ဖြစ်၊ range များများလိုတဲ့အချိန်မှာ DOUBLE ကိုသုံးပါတယ်။
* BOOLEAN – TRUE/FALSE တန်ဖိုးနှစ်ခုထဲသာရှိတဲ့ Logical value သိမ်းဆည်းရန်
## Character Data Types
* CHAR – fixed-length ဖြစ်တဲ့စာသားတွေသိမ်းဆည်းရန်။
* VARCHAR – maximum length ကို define လုပ်ပြီးသိမ်းဆည်းနိုင်ပါတယ်။
* TEXT – သိမ်းဆည်းရမယ့် စာသားကိုများတယ်ဆို TEXT ကိုအသုံးပြုနိုင်ပါတယ်။ MEDIUMTEXT, LONGTEXT အစရှိတာတွေကိုအသုံးပြုနိုင်ပါတယ်။
## Date & Time Data Types
* Date – YYYY-MM-DD format နဲ့ Year, Month, Date တန်ဖိုးတွေသိမ်းဆည်းရန်
* Time – HH:MM:SS format နဲ့ နာရီ၊မိနစ်၊ စက္ကန့် တန်ဖိုးတွေသိမ်းဆည်းရန်
* DATETIME/TIMESTAMP – Date နဲ့ Time ကိုပေါင်းစည်းပြီးသိမ်းဖို့လိုတဲ့အချိန်တွေအသုံးပြုရန်
အခုအပေါ်မှာပြောခဲ့တာတွေကတော့ အသုံးပြုတာများတဲ့ data types တွေပဲဖြစ်ပါတယ်။ storage size တွေကိုတော့ ကျနော်လည်းအလွတ်မရပါဘူး၊ လိုအပ်တဲ့အချိန်မှသာသက်ဆိုင်ရာ documentation ကိုပြေးကြည့်လိုက်တာပဲ။ W3Schools မှာတော့ data types တွေကိုဒီလိုပိုမိုတိတိကျကျဖော်ပြထားပါတယ်။ Reference အနေနဲ့ထည့်သွင်းဖော်ပြပေးလိုက်ပါတယ်။ MySQL Data Types (Version 8.0) အတွက်ဖြစ်ပါတယ်။ (DBMS အလိုက်ပြောင်းလဲနိုင်တာကြောင့် အသုံးပြုတဲ့ DBMS နဲ့ version ကိုပူးတွဲဖော်ပြခြင်းဖြစ်ပါတယ်)
  
ဒီ URL ကနေတစ်ဆင့်လည်းသွားရောက်ဖတ်ရှုနိုင်ပါတယ်။
## Why Data Types?
ဘာလို့ data types တွေကအရေးကြီးတာလဲဆိုတော့
### Data Integrity
Product description သိမ်းဆည်းရမယ့်နေရာမှာ TEXT လိုမျိုး data type သုံးခြင်းအားဖြင့် description text data တွေပြတ်တောက်ခြင်းမရှိဘဲခိုင်မာမှုကောင်းကောင်းနဲ့သိမ်းဆည်းနိုင်ပါတယ်။ ဥပမာ Varchar ကို size 20 လောက်သတ်မှတ်ပြီးသိမ်းလိုက်မယ်ဆို data ဖြတ်ချခံရနိုင်တဲ့ဖြစ်နိုင်ချေရှိပါတယ်။
### Storage Optimization
Data ကိုလိုသလောက်ပဲ data type တွေခွဲခြားသတ်မှတ်ပေးခြင်းအားဖြင့် data storage ပမာဏကိုလျော့ချနိုင်ပါတယ်။ ဥပမာ ဒီ row ကဖျက်ထားလားဆိုတဲ့ is\_deleted ဆိုတဲ့ column လိုမျိုးကို BOOLEAN လို value ကိုသုံးသင့်ပါတယ်။ INT တို့ MEDIUMINT တို့သုံးလိုက်မယ်ဆို မလိုအပ်ဘဲ storage ပမာဏပိုပေးရပါတယ်။
### Query Optimization
Data တွေကို filter, sort လုပ်ဖို့အတွက် data type တွေခွဲထားမှသာအဆင်ပြေပါမယ်။ ဥပမာ monthly data ဆွဲမယ်ဆို column ကို DATE data type နဲ့သိမ်းထားမှသာ query ကိုကောင်းမွန်စွာ ဆွဲနိုင်မှာဖြစ်ပါတယ်။
### Calculation
အတွက်အချက်နဲ့ပတ်သတ်တဲ့ query တွေ run ဖို့လိုအပ်လာချိန်မှာလည်း သင့်တော်တဲ့ data type တွေခွဲထားမှသာ calculation ကောင်းကောင်းလုပ်နိုင်မှာဖြစ်ပါတယ်။ ဥပမာ INT သိမ်းရမယ့် column လိုနေရာမျိုးမှာ TEXT နဲ့သိမ်းထားမယ်ဆို calculation လုပ်တဲ့နေရာမှာအခက်အခဲတွေရှိနိုင်ပါတယ်။
# Environment Setup
SQL အသုံးပြုဖို့အတွက် MySQL DBMS ကိုအသုံးပြုသွားကြပါမယ်။
ဒီ article မှာတော့ MySQL ကို Window, macOS, Linux system တွေမှာ installation လုပ်ဖို့အတွက် screenshots တွေနဲ့တကွ guide လုပ်ပေးသွားပါမယ်။
## Window
MySQL installation url ကိုသွားလိုက်ပါမယ်။
ကိုယ့် system နဲ့ကိုက်ညီတဲ့ download option ကိုရွေးပါ။
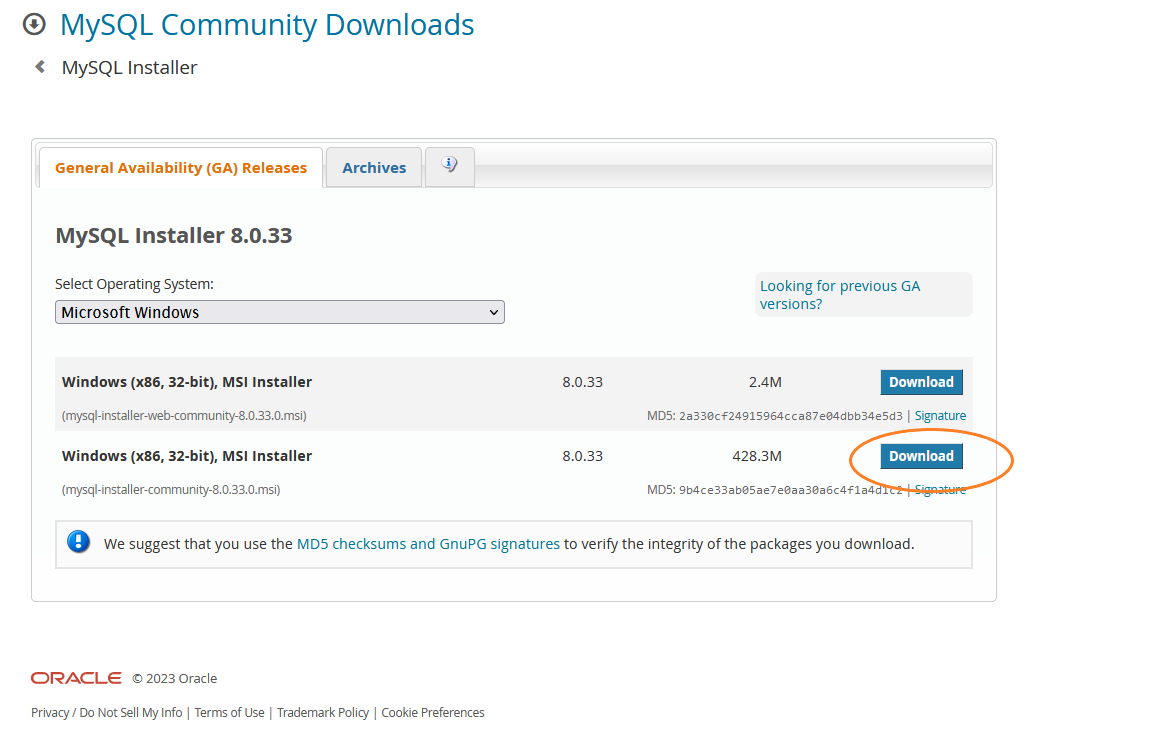
no thanks, just start my download ကိုနှိပ်ပြီး download ချပါမယ်။

exe file ကို double click လုပ်ပြီး installation ကိုစတင်ပါမယ်။
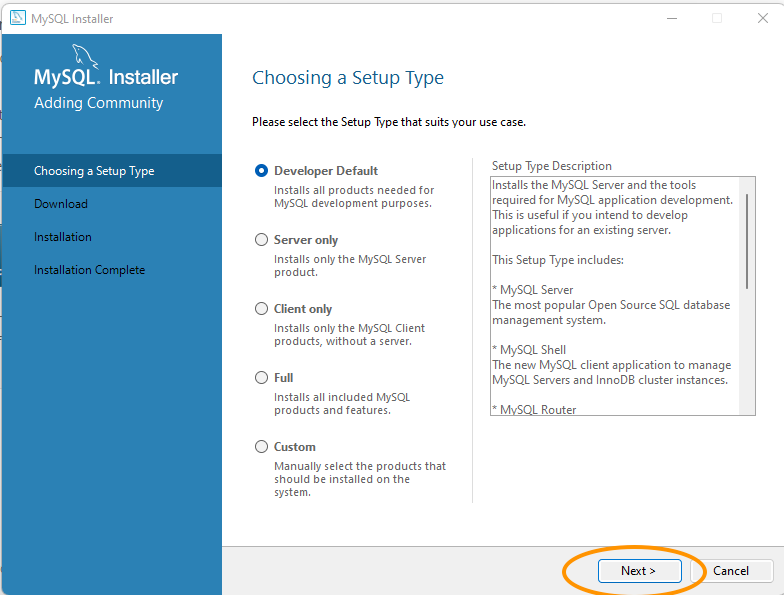
developer default ကိုရွေးပီး next နှိပ်ပါမယ်။
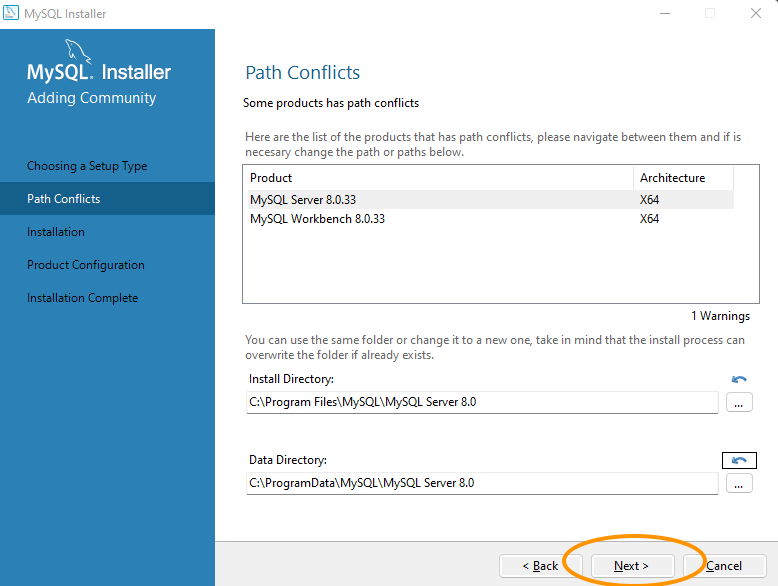
Path ကိုရွေးပြီး next နှိပ်ပါမယ်။
Execute ကိုနှိပ်ပြီး install စပါမယ်။
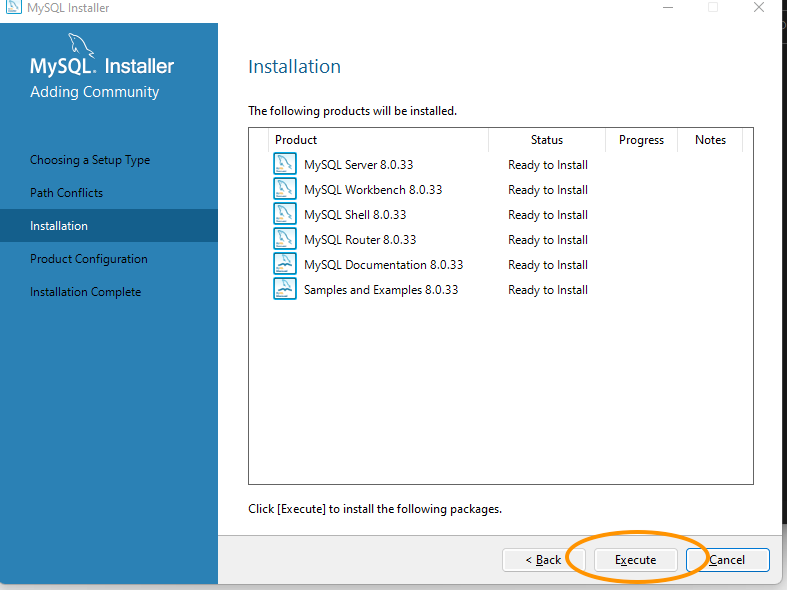
Next နှိပ်ပါမယ်။
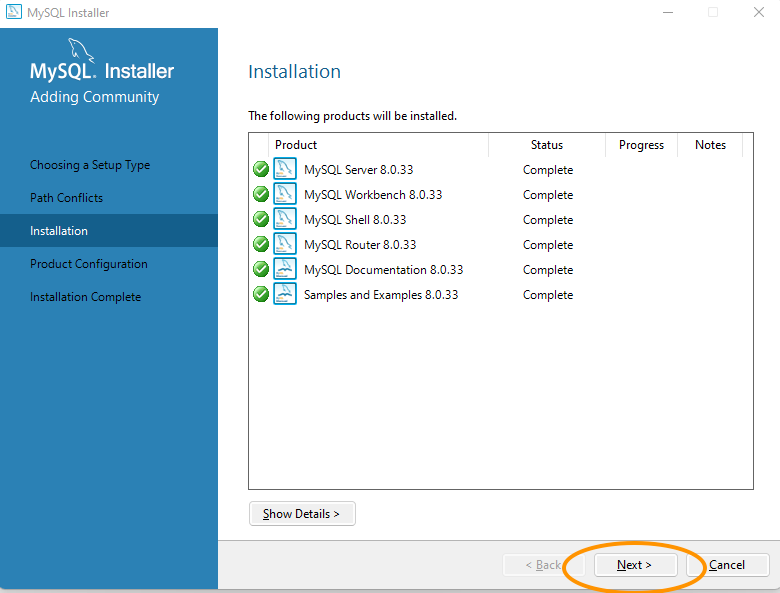
Next နှိပ်ပါမယ်။
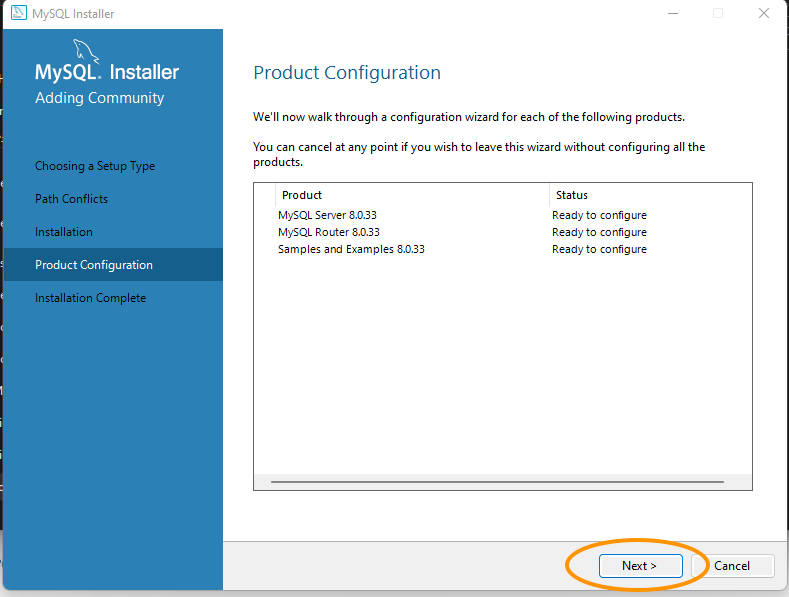
Setting ကိုစစ်ပြီး Next နှိပ်ပါမယ်။
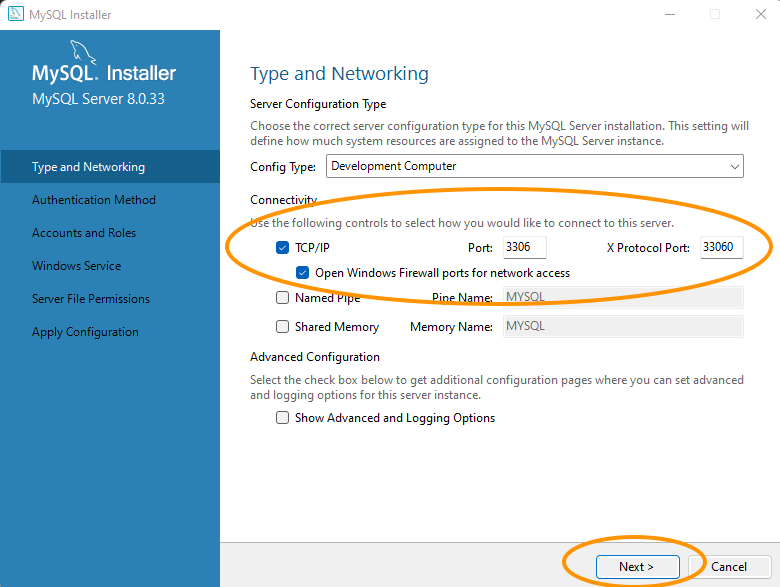
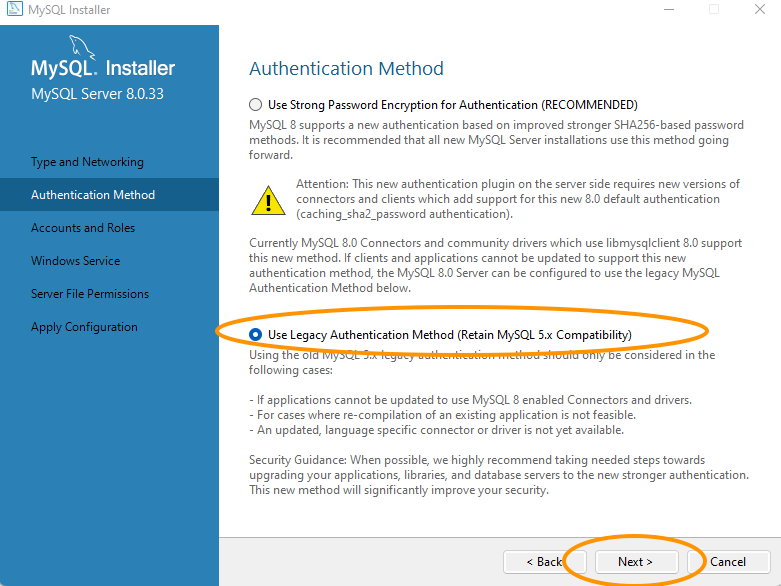
legacy authentication method ကိုရွေးပြီး Next နှိပ်ပါမယ်။ အကယ်လို့ local environment မဟုတ်ဘဲ production environment တွေမှာဆိုရင်တော့ strong password option မျိုးကိုရွေးသင့်ပါတယ်။ local ကိုယ့်စက်ထဲမှာတော့ကြိုက်တာရွေးထည့်ထားနိုင်ပါတယ်။\
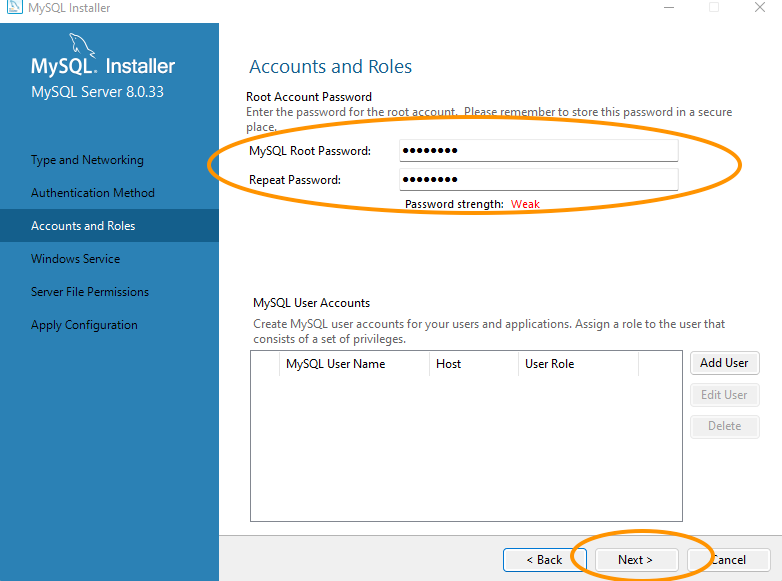
Password ထည့်ပြီး Next နှိပ်ပါမယ်။
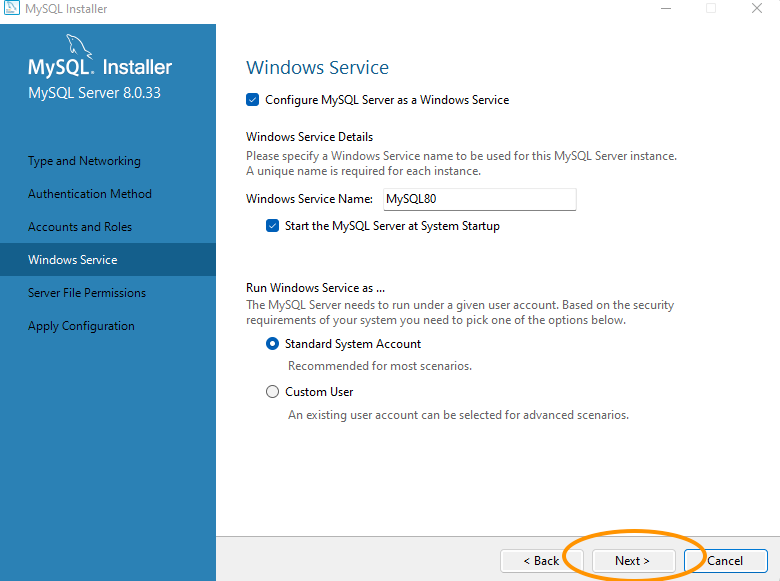
Next နှိပ်ပါမယ်။
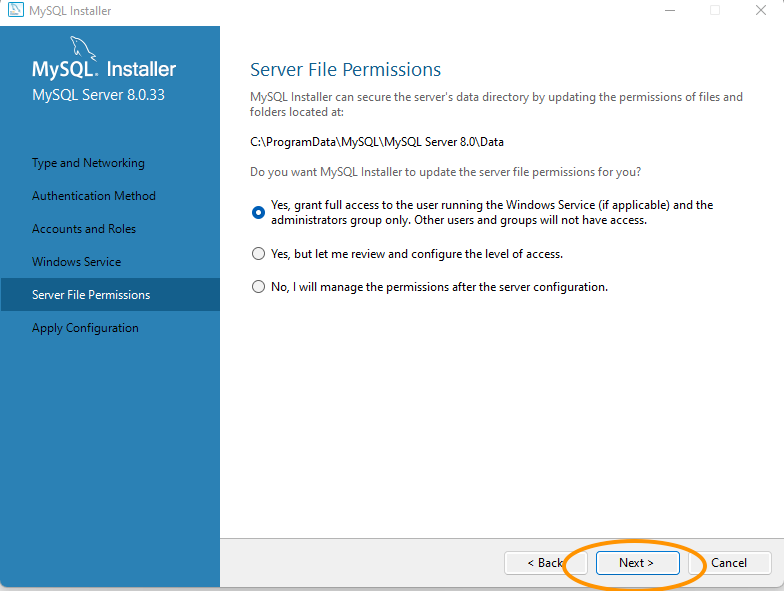
Full access grant လုပ်ပြီး Next နှိပ်ပါမယ်။
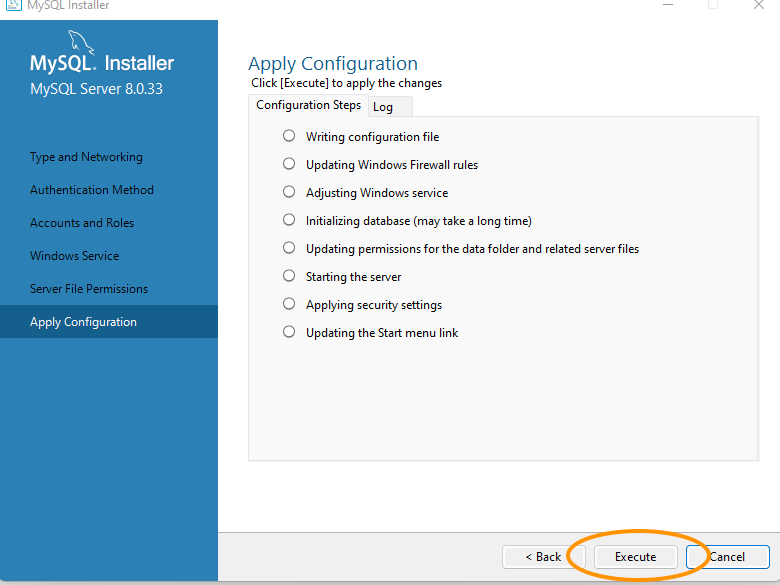
Configuration တွေ applyလုပ်ဖို့အတွက် execute ကိုနှိပ်ပါမယ်။
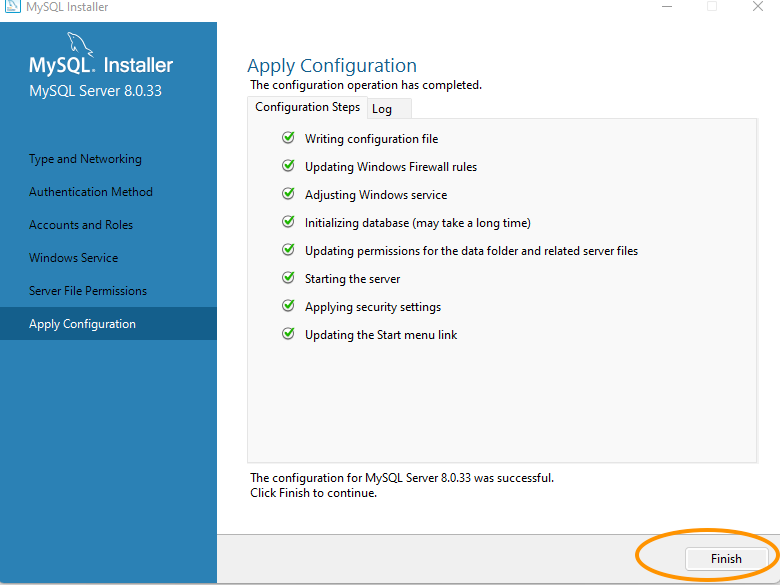
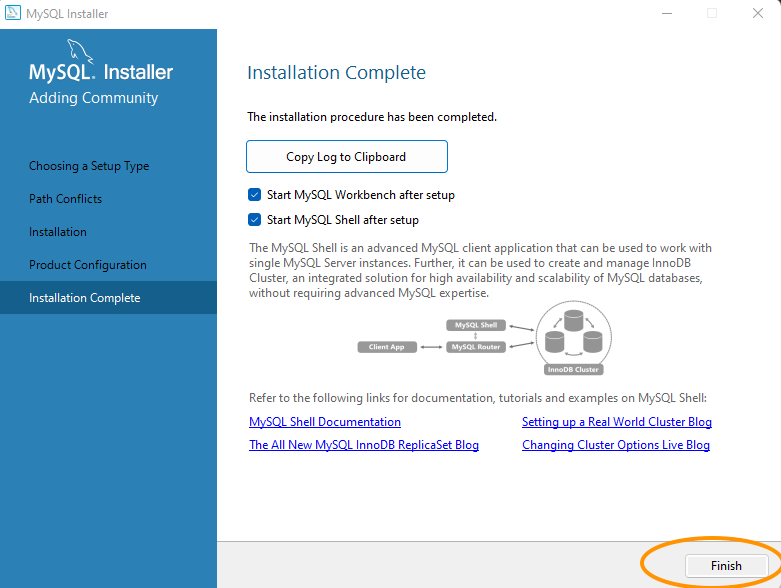
Finish ကိုနှိပ်ပါမယ်။
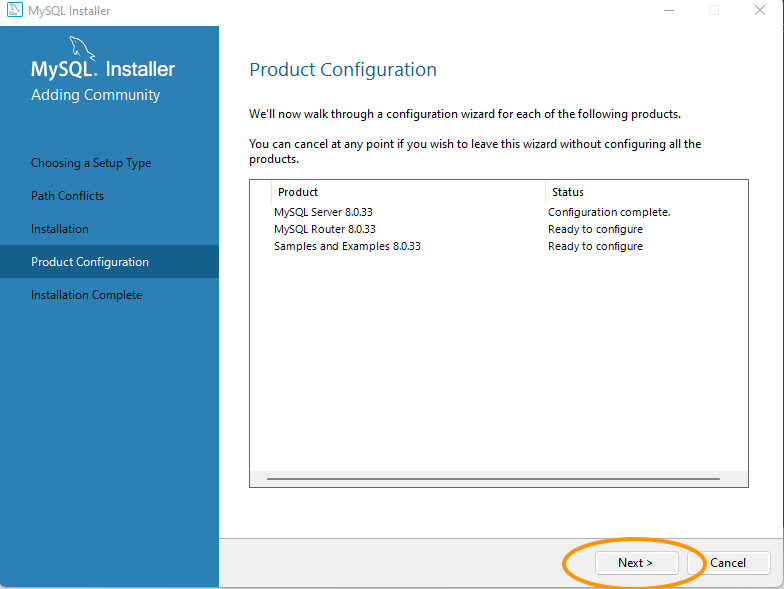
Product configurationsတွေထပ်လုပ်ဖို့အတွက် next ကိုနှိပ်ပါမယ်။
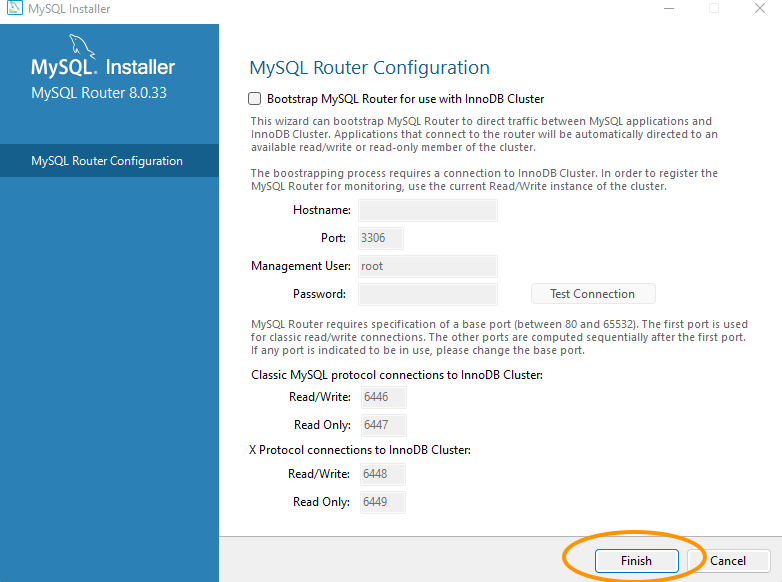
Finish ကိုနှိပ်ပါမယ်။
Samples configuration အတွက် next ကိုနှိပ်ပါမယ်။
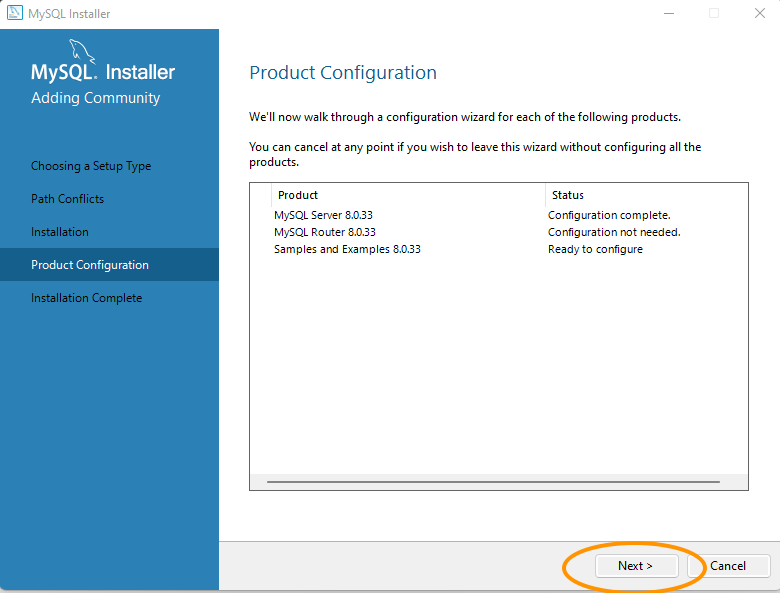
Username, password ထည့်ပြီး check ကိုနှိပ်ပါမယ်။ အဆင်ပြေတယ်ဆိုရင် next ကိုနှိပ်ပါမယ်။
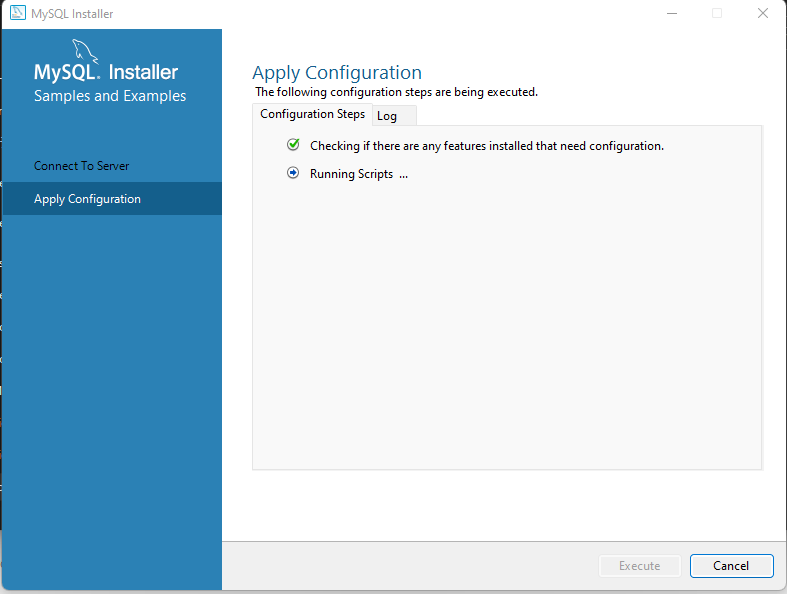
Setup ပြီးပါပြီ၊ next ကိုနှိပ်ပါမယ်။
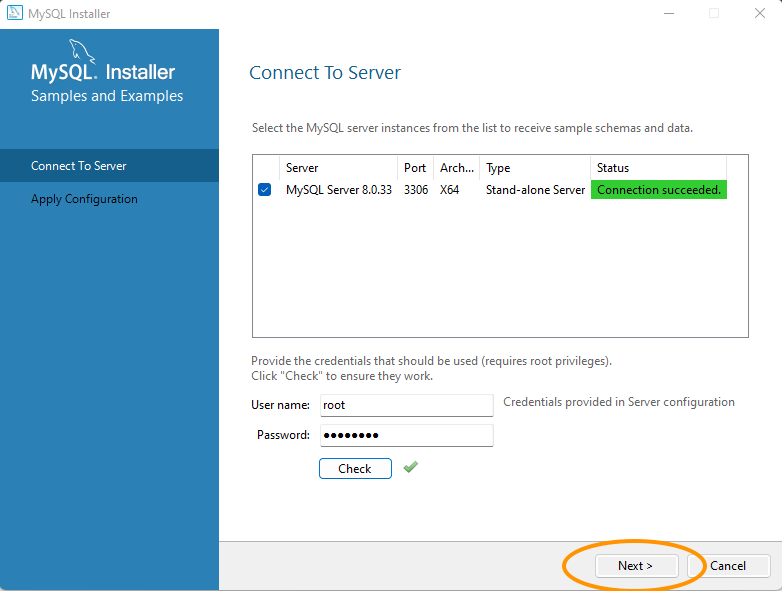
\
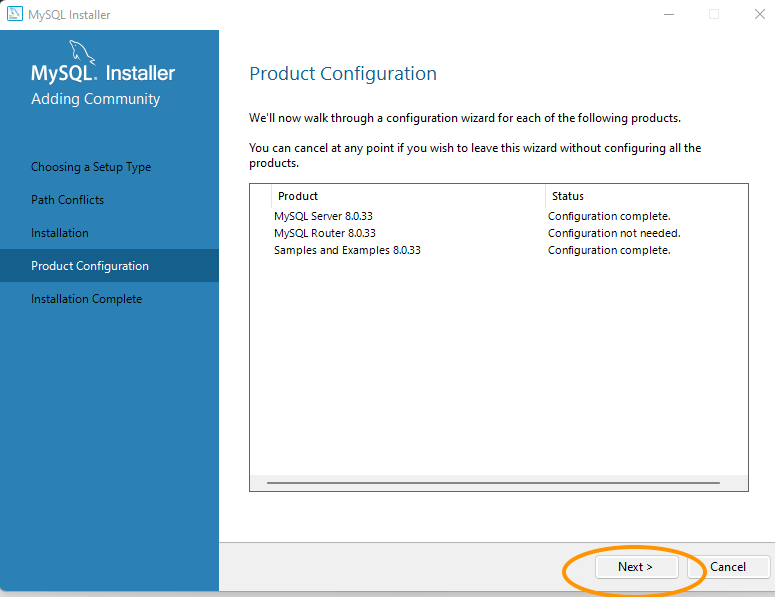
Finish ကိုနှိပ်ပါမယ်။
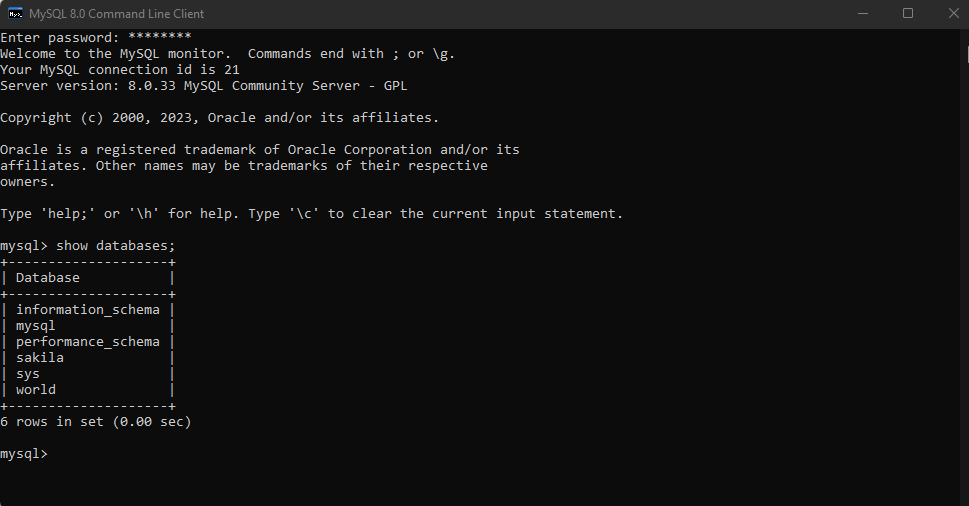
Start menu ကနေ MySQL 8.0 command line client ဆိုပြီးရိုက်ရှာပြီးဖွင့်လိုက်ပါမယ်။
အရှေ့မှာထည့်ခဲ့တဲ့ password ကိုဖြည့်လိုက်မယ်ဆို MySQL အသုံးပြုနိုင်ပါပြီ။
show databases လို့ရိုက်ကြည့်ပြီး database list ကို checkup လုပ်ကြည့်ထားနိုင်ပါတယ်။
## macOS
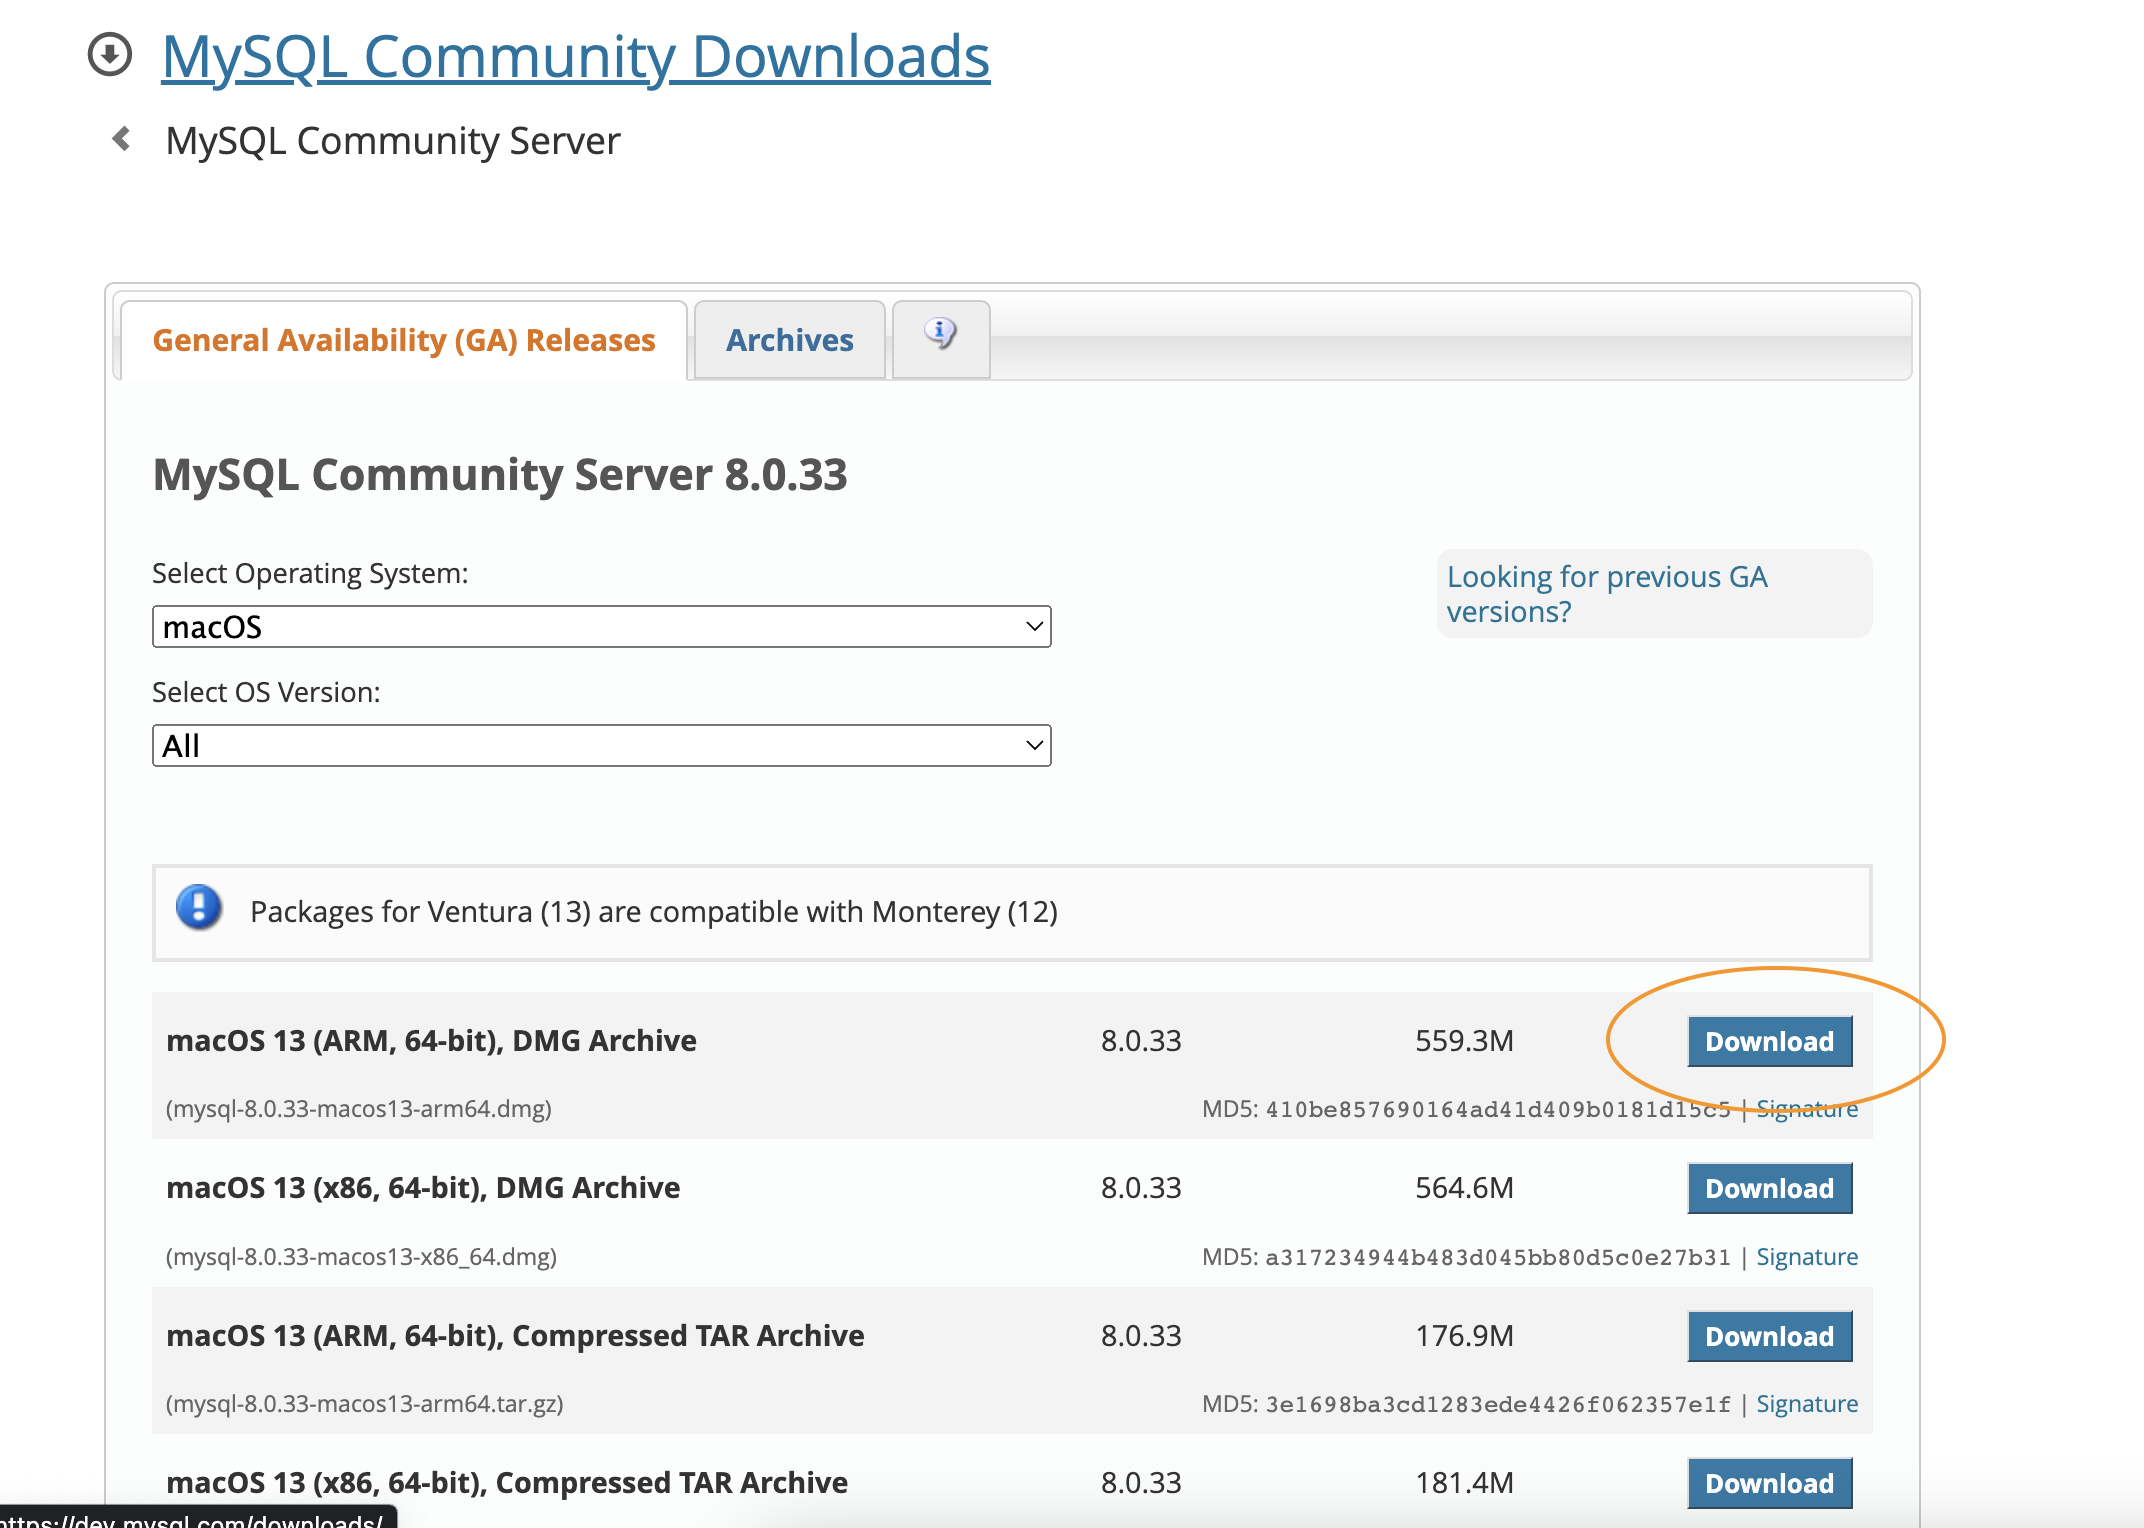
Download link ကနေမှတစ်ဆင့် macOS ကိုရွေးလိုက်ပါ။
ကိုယ့်ရဲ့ macOS system ကိုအောက်ပါအတိုင်းစစ်နိုင်ပါတယ်။
apple icon ကနေမှ about this mac ကိုရွေး System Report ကိုနှိပ်လိုက်မယ်ဆို system report ကိုမြင်ရမှာဖြစ်ပါတယ်။
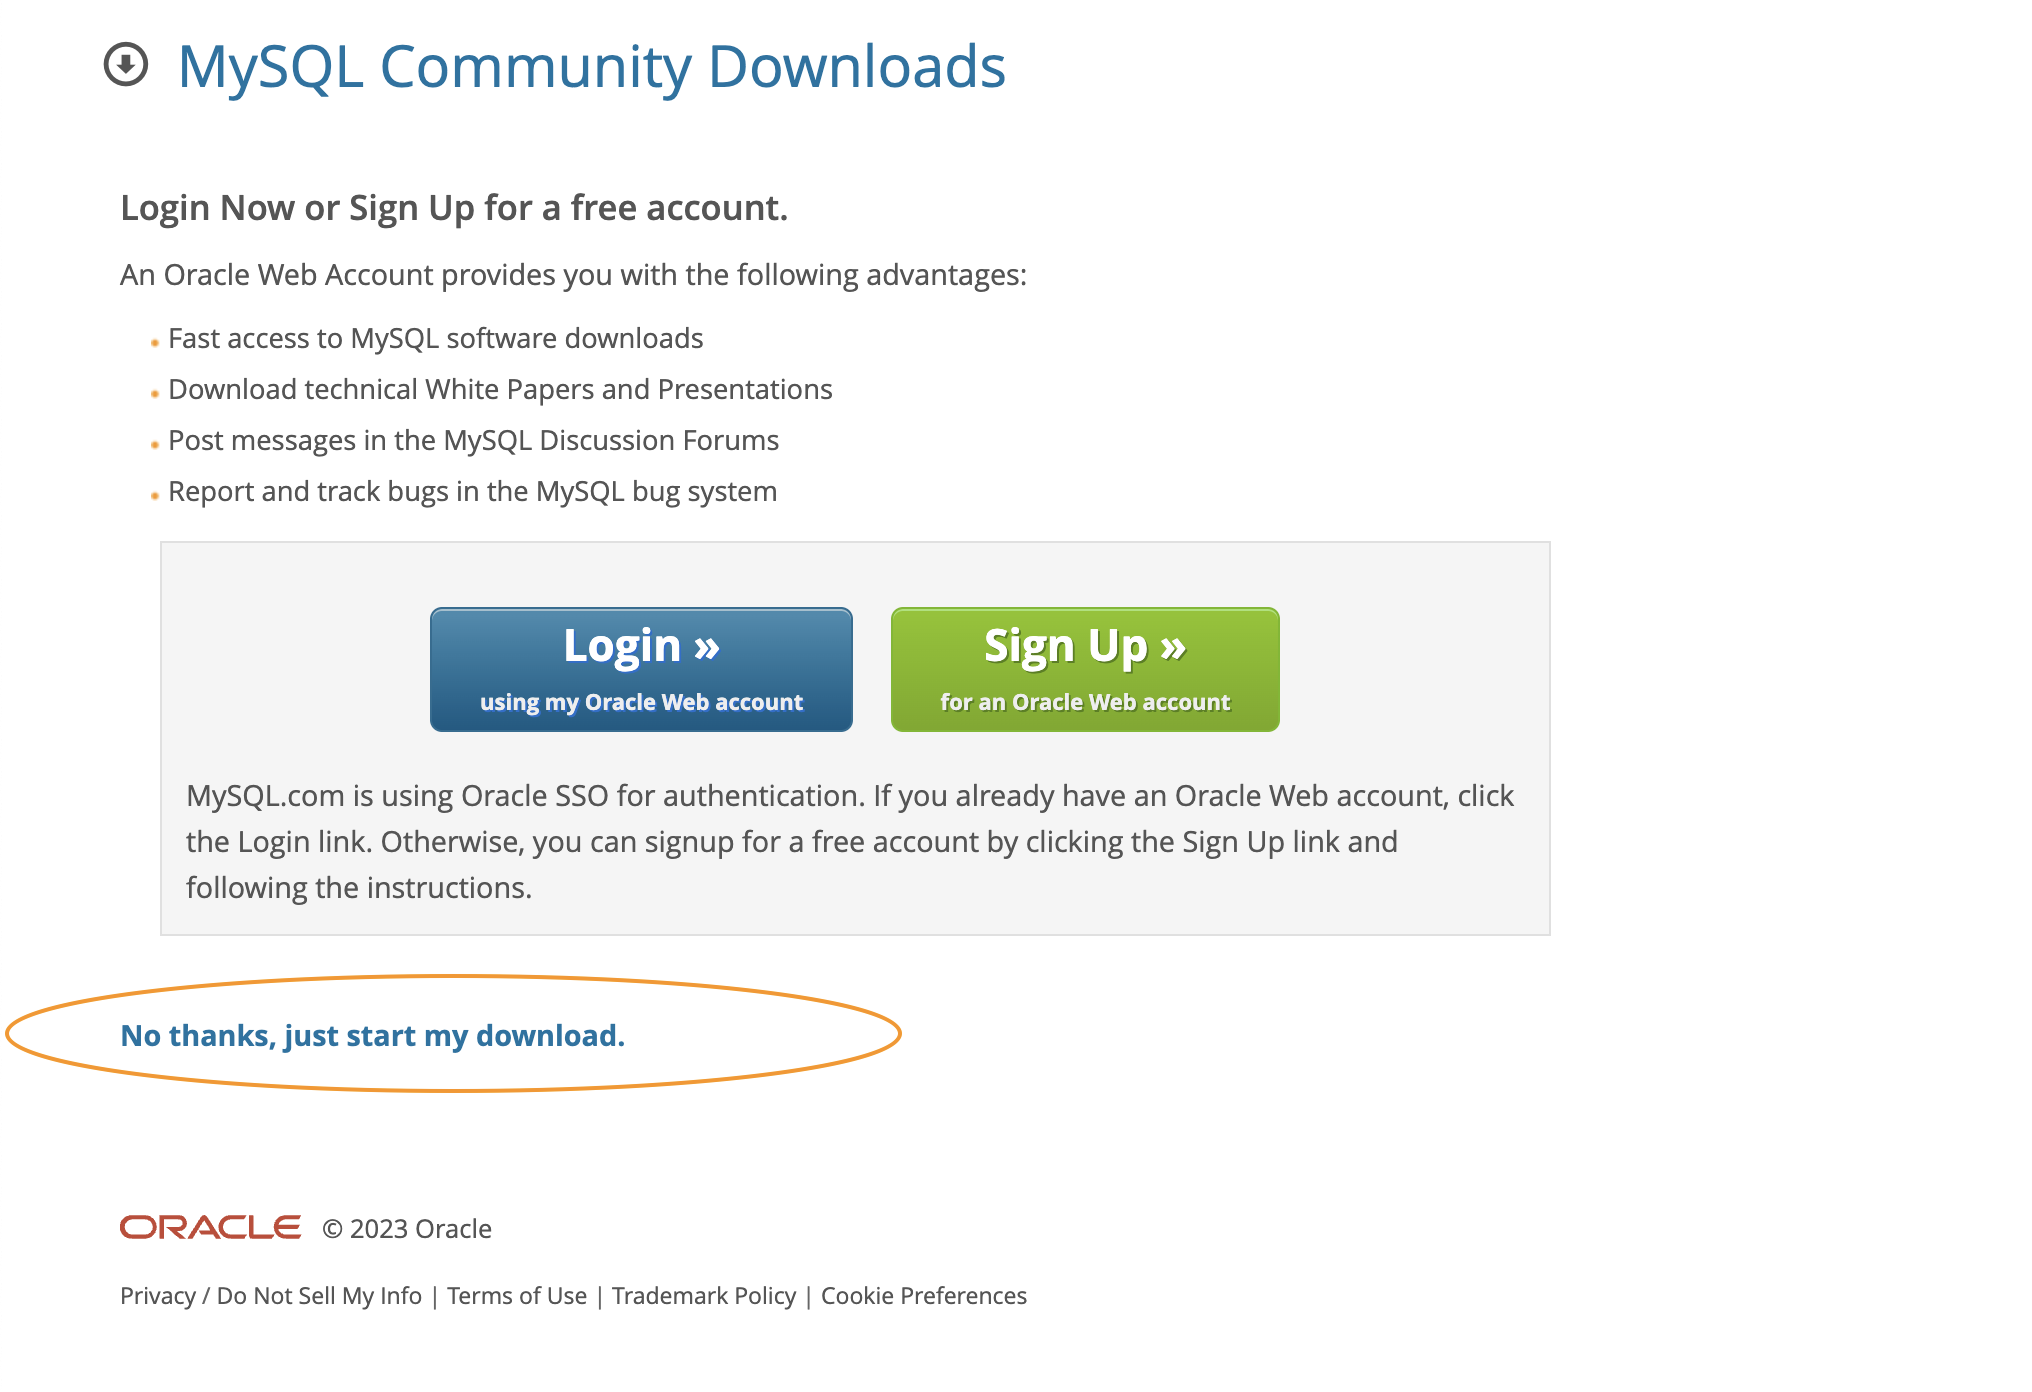
no thanks, just start my download ကိုနှိပ်ပြီး installer ကို download ချနိုင်ပါတယ်။
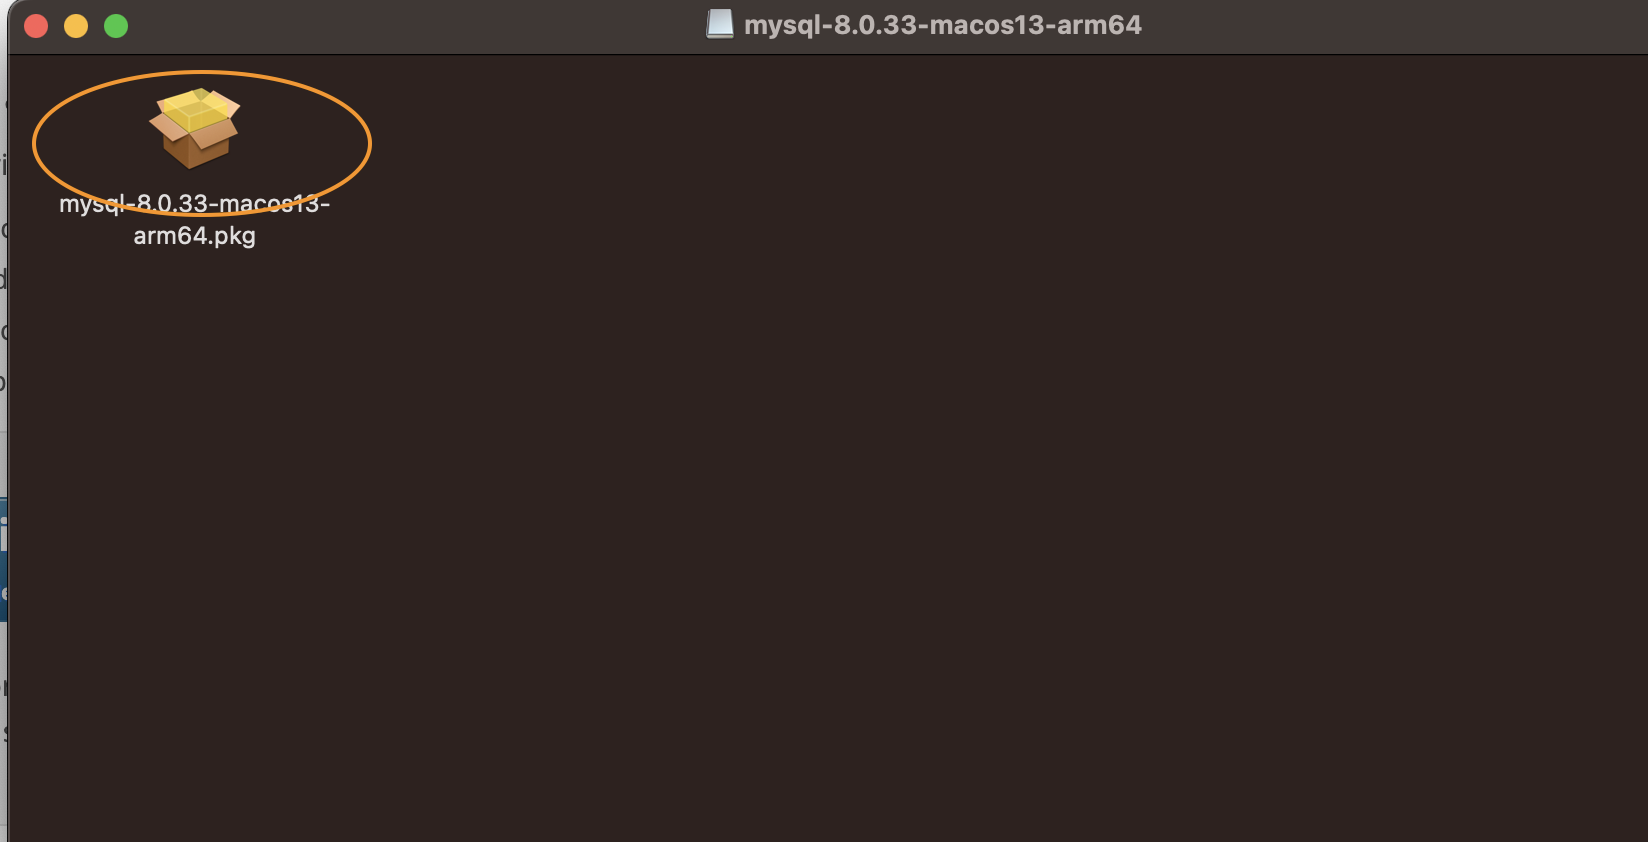
Double click လုပ်ပြီး installation ကိုစတင်ပါမယ်။
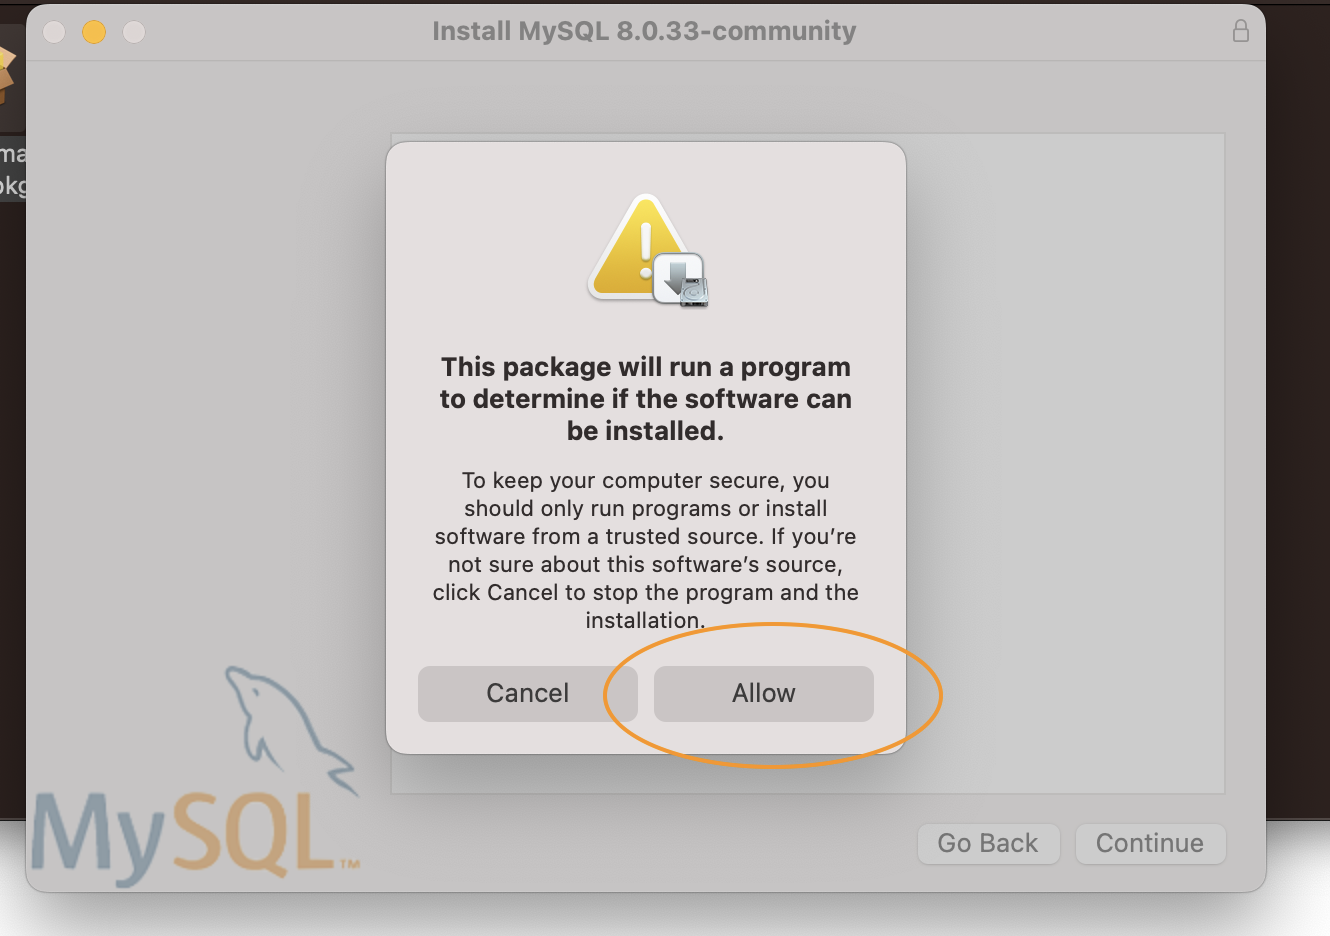
Allow ကိုနှိပ်ပါမယ်။
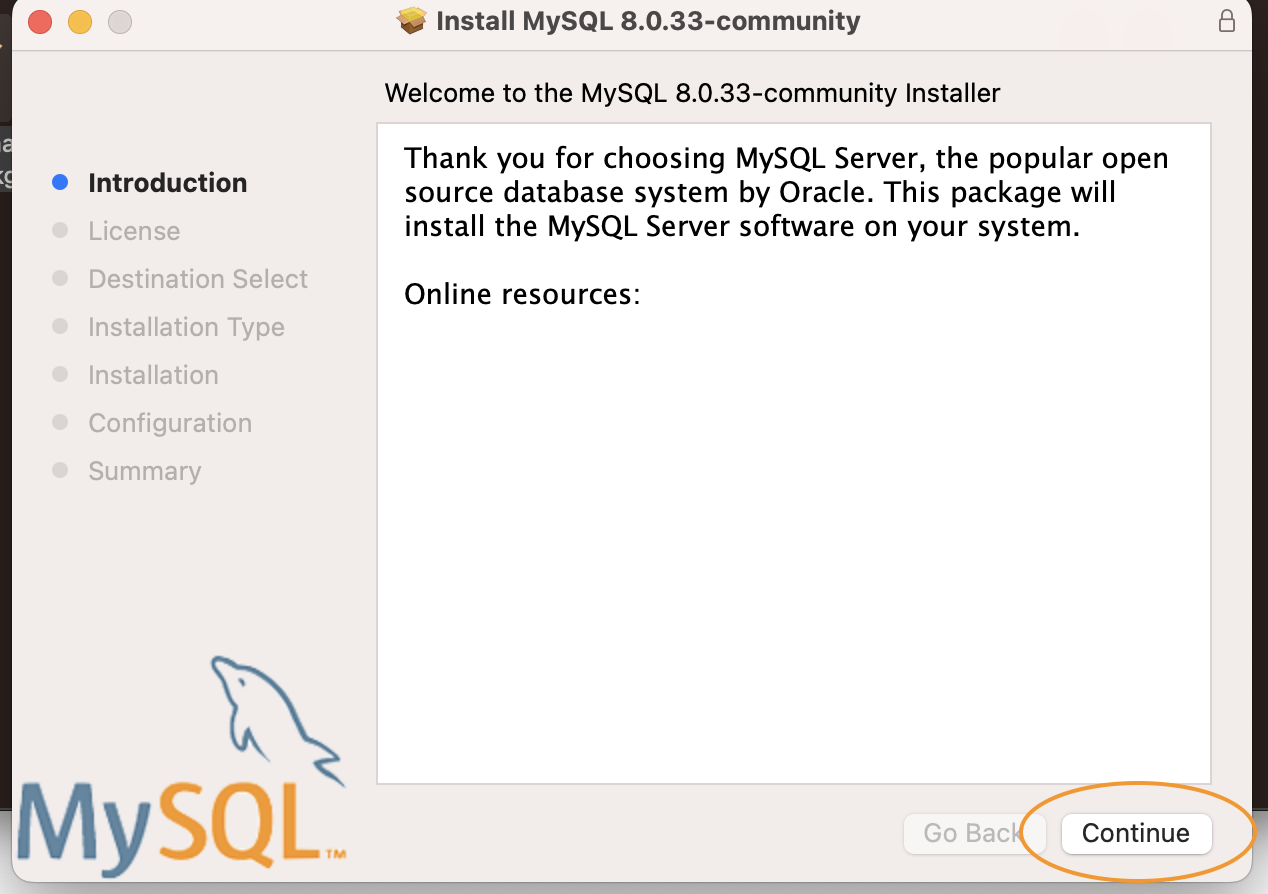
Continue ကိုနှိပ်ပါမယ်။
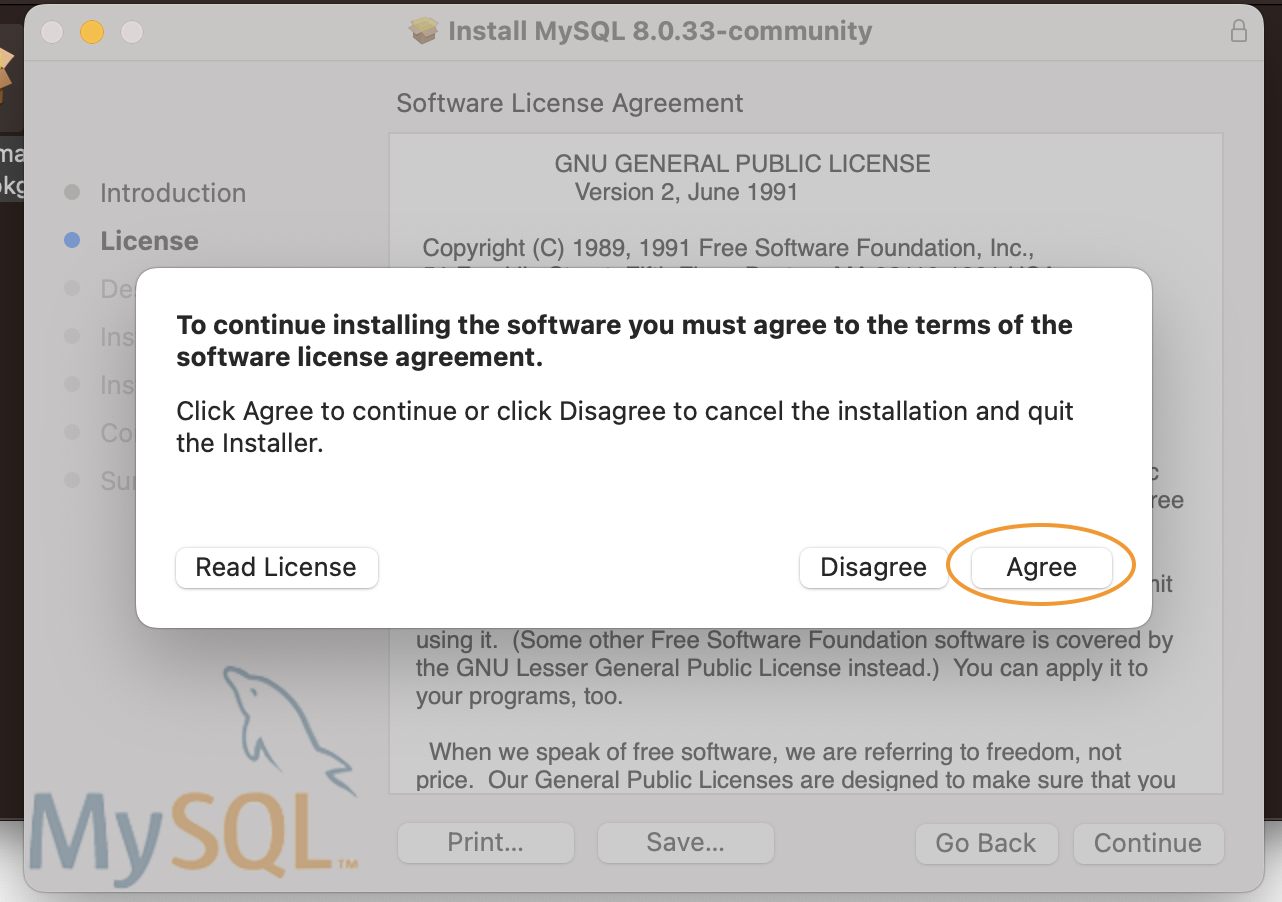
License agree လုပ်ပါမယ်။
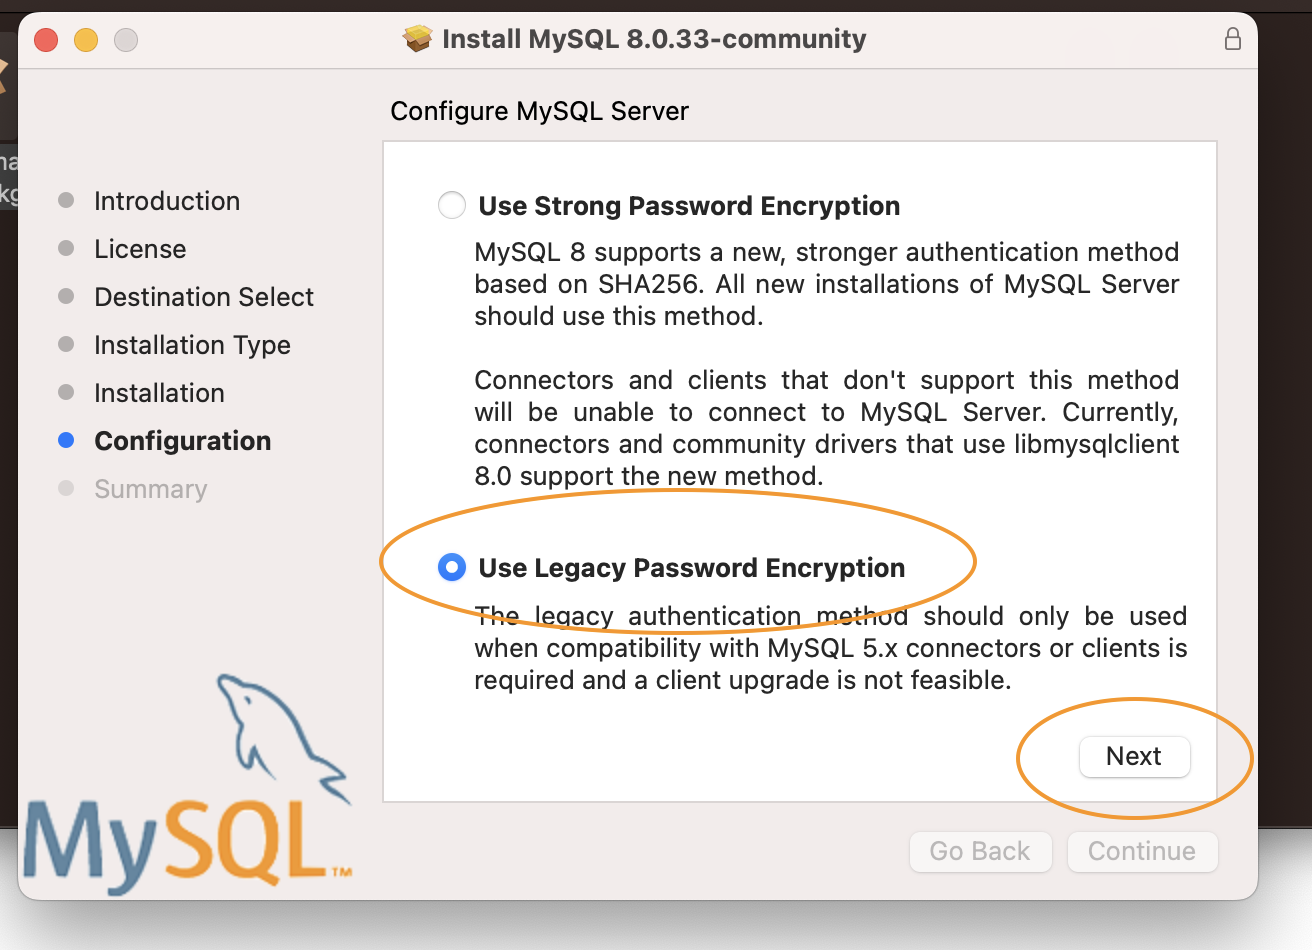
use legacy password ကိုရွေးပြီး next ကိုနှိပ်ပါမယ်။ local environment ကိုယ့်စက်ထဲမှာတော့ကြိုက်တာရွေးနိုင်ပေမယ့် production environment လိုမျိုးမှာ strong password option မျိုးကိုရွေးသင့်ပါတယ်။
Password ရိုက်ထည့်ပါ။
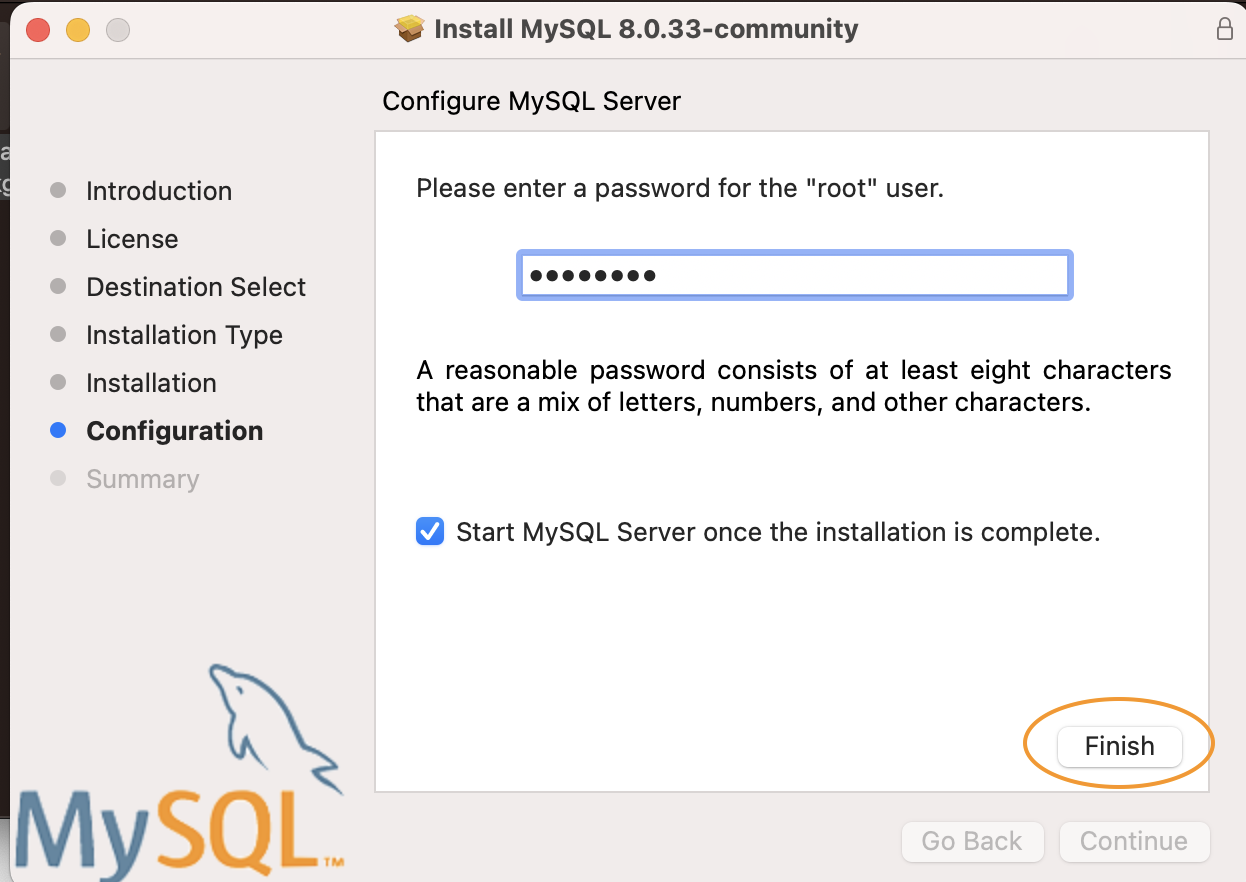
Installation ပြီးပါပြီ၊ close ကိုနှိပ်ပါမယ်။

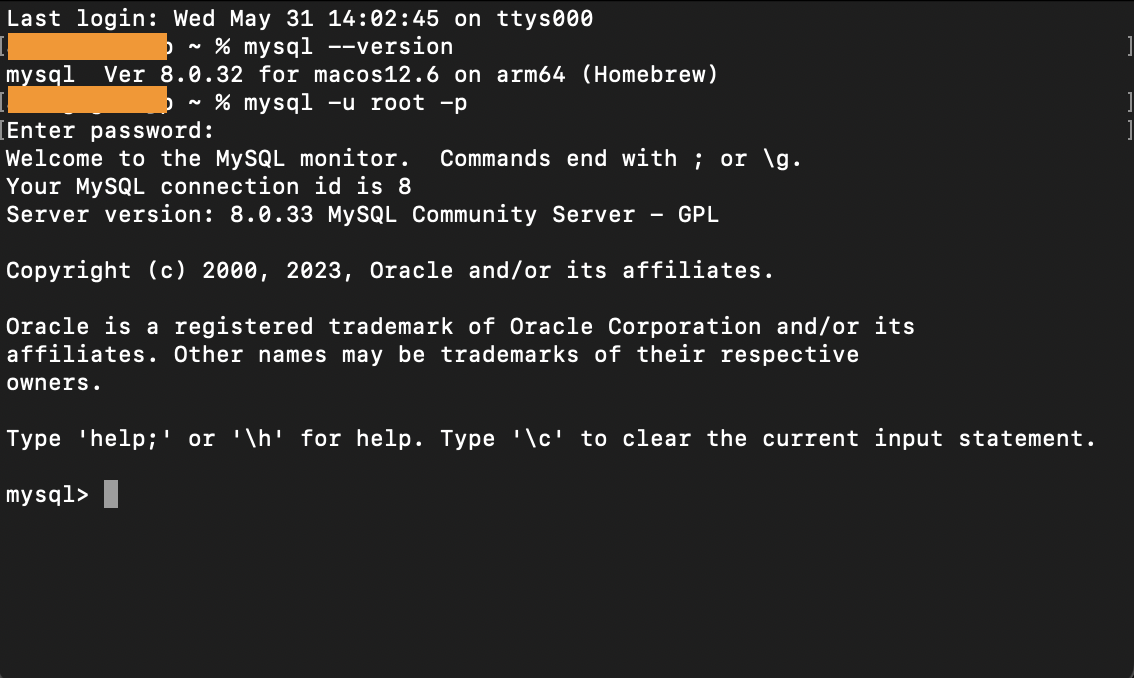
Terminal ဖွင့်ပြီး
`mysql –-version`
လို့ရိုက်ကြည့်လိုက်မယ်ဆို MySQL version ကိုမြင်ရပါမယ်။
`mysql -u root -p`
ရိုက်ပြီး MySQL ကို login ဝင်ကြည့်ပါမယ်။
Password ရိုက်ထည့်လိုက်မယ်ဆို MySQL အသုံးပြုနိုင်ပါပြီ။
## Linux
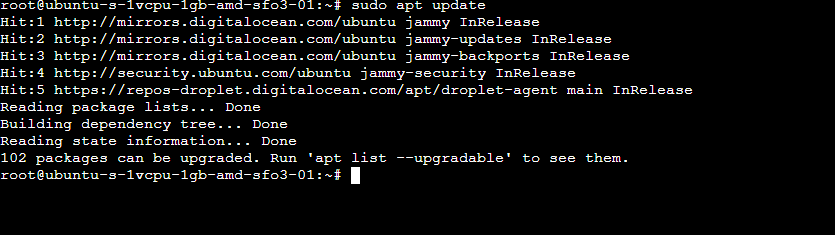
Packages list ကိုအရင် update လုပ်ပါမယ်။
`sudo apt update`
mysql-server သွင်းပါမယ်။
`sudo apt install mysql-server`

သွင်းပြီးတဲ့အခါ MySQL version ကိုစစ်ကြည့်ပါမယ်။ version ပေါ်လာရင်သွင်းတာအောင်မြင်ပါတယ်။
`mysql --version`
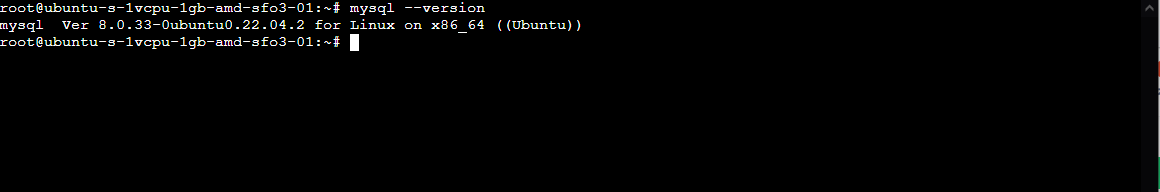
MySQL ကို login ဝင်ကြည့်ပါမယ်။ လောလောဆယ်တော့ password မရှိသေးတော့ ဒီအတိုင်းဝင်သွားပါလိမ့်မယ်။
`mysql -uroot`

MySQL shell ထဲရောက်ပါပြီ။ password ထည့်ပါမယ်။
Password ကိုတော့ ‘password’ လို့ပဲပေးလိုက်ပါတယ်၊ ကြိုက်တာပေးလို့ရပါတယ်၊ ၈လုံးတော့ရှိဖို့လိုပါတယ်။
`ALTER USER 'root'@'localhost' IDENTIFIED WITH mysql_native_password by 'password'`

MySQL shell ထဲကနေ `exit` လို့ရိုက်ပြီးထွက်လိုက်ပါတယ်။
`mysql -u root -p`
လို့ရိုက်ပြီး password အသစ်နဲ့ Login ပြန်ဝင်ကြည့်ပါမယ်။
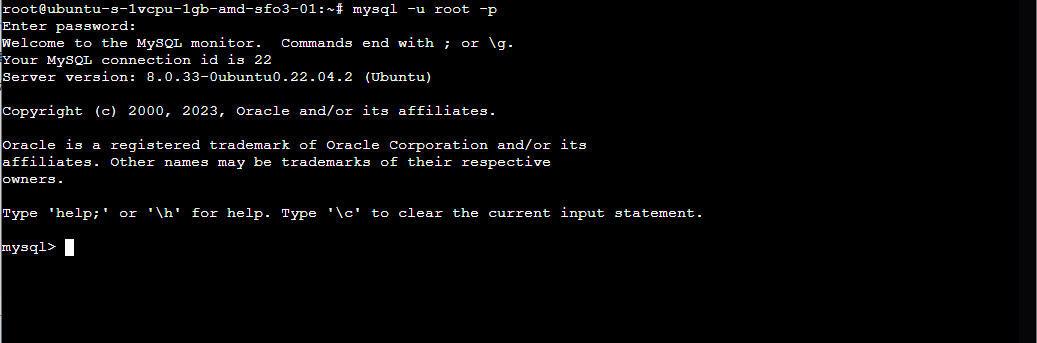
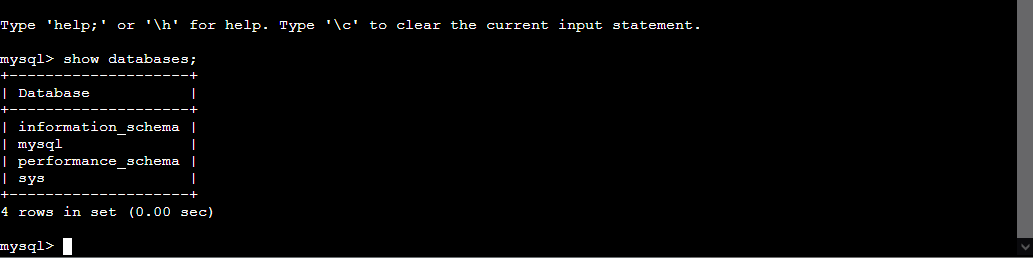
`show databases` လို့ရိုက်ပြီး database list check လုပ်ကြည့်ပါမယ်။
# Diving Into SQL Queries
# Query Introduction
Diving လုပ်တယ်လို့ဆိုထားပေမယ့် ဒီအပိုင်းမှာတော့ Query ဆိုတာဘယ်လိုသဘောရှိလဲဆိုတာကို သဘောပေါက်ရုံလောက်ပဲ intro အရင်ဝင်ပြီးတော့ဖြည်းဖြည်းခြင်း step up လုပ်ပြီးလေ့လာသွားကြပါမယ်။
Query တွေရေးတဲ့အချိန်မှာ CLI (command line interface) ကိုအသုံးပြုသွားပါမယ်။ CLI နဲ့ရင်းနှီးစေချင်တာကတစ်ကြောင်း၊ CLI မကျွမ်းကျင်သေးဘဲနဲ့ GUI (graphical user interface) ကိုတန်းမသုံးစေချင်တာကြောင့်လည်းပါပါတယ်။
စလိုက်ကြရအောင်၊ ကျနော်ကတော့ window OS ကိုအသုံးပြုနေပါတယ်။ တစ်ခြား OS အသုံးပြုနေတဲ့သူတွေကလည်းသက်ဆိုင်ရာ application ကိုဖွင့်ပြီးလိုက်လုပ်ကြည့်နိုင်ပါတယ်။ နားမလည်ရင် environment setup အပိုင်းကိုပြန်ဖတ်ကြည့်ပေးပါခင်ဗျ။
MySQL 8.0 command line client ကို window start menu ကနေတစ်ဆင့်ဖွင့်လိုက်ပါမယ်။ password ရိုက်ထည့်ပြီးရင်အသုံးပြုနိုင်ပါပြီ။

Query တွေစမ်းရေးကြည့်နိုင်ဖို့အတွက် Database တစ်လုံးအရင်ဆောက်ကြည့်ရအောင်။ Database ဆောက်ဖို့အတွက် schema ပါ။
#### Schema
`CREATE DATABASE database_name;`
`database_name` မှာကျနော်တို့ဆောက်မည့် နာမည်ကိုအစားထိုးလိုက်ပါမယ်။ ဒီတစ်ခေါက်စားသောက်ဆိုင်ဆိုတဲ့ restaurant db ကိုဆောက်ပါမယ်။
#### Query
`CREATE DATABASE restaurant;`
`show databases` ကိုသုံးပြီးပြန်စစ်ကြည့်မယ်ဆို restaurant db ကိုတွေ့ရပါမယ်။

ဆောက်ထားတဲ့ restaurant db ကိုအသုံးပြုရန် `use restaurant` ဆိုပြီးရိုက်လိုက်ပါမယ်။

ဆိုင်မှာရနိုင်တဲ့ဟင်းပွဲတွေကိုသိမ်းဖို့အတွက် menu ဆိုတဲ့ table ဆောက်ပါမယ်။
#### Schema
```
CREATE TABLE table_name (
column_name1 data_type1 constraints,
column_name2 data_type2 constraints,
...
);
```
table\_name နေရာမှာ table နာမည် column\_name နေရာမှာထည့်ချင်တဲ့ column နာမည် data\_type နေရာမှာသိမ်းဆည်းချင်တဲ့ပုံစံ constraints မှာလိုတဲ့ပမာဏကိုထည့်ပြီး table ဆောက်ပါမယ်။
#### Query
```
CREATE TABLE menu (name VARCHAR(100), price INTEGER(10), category VARCHAR(50), created_date DATE, updated_date DATE );
```
`show tables` နဲ့ပြန်စစ်ကြည့်မယ်ဆို ဒီလိုမြင်ရပါလိမ့်မယ်။

Table structure ကိုပါကြည့်ချင်တယ်ဆို `DESCRIBE` ဆိုတဲ့ keyword ကိုအသုံးပြုနိုင်ပါတယ်။

Table ဆောက်ပြီးပြီဆိုတော့ data နည်းနည်းထည့်ကြည့်ရအောင်။
#### Schema
```
INSERT INTO table_name (column1, column2, ...)
VALUES (value1, value2, ...),
(value1, value2, ...),
...;
```
column နေရာမှာ column name တွေအစားထိုးပြီး value နေရာမှာထည့်ချင်တဲ့တန်ဖိုးတွေကိုအစားထိုးလိုက်ပါမယ်။
#### Query
```
INSERT INTO menu (name, price, category, created_date, updated_date) VALUES ('Dish A', 10000, 'Main Course', '2023-07-28', '2023-07-28'), ('Dish B', 6000, 'Appetizer', '2023-07-28', '2023-07-28'), ('Dish C', 5000, 'Dessert', '2023-07-28', '2023-07-28');
```

Data တွေကိုပြန်စစ်ကြည့်ရအောင်။
`select * from menu`

menu table ထဲမှာရှိတဲ့ data အားလုံးကိုပြပါလို့ဆိုလိုတာဖြစ်ပါတယ်။ SELECT နဲ့ FROM keyword ကိုအသုံးပြုပါတယ်။ `*` ကတော့အားလုံးကိုဆိုလိုခြင်းဖြစ်ပါတယ်။
အားလုံးကိုမဆွဲထုတ်ချင်ဘူး၊ column တစ်ခုတည်းဆွဲချင်တယ်ဆိုလည်းရပါတယ်။ `*` နေရာမှာ column name ကိုအစားထိုးလိုက်ရုံပါပဲ။
#### Query
`select name from menu;`

တစ်ခုထက်ပိုတဲ့ column ကိုဆွဲချင်တယ်ဆိုရင်လည်း comma ခံပြီးဆွဲထုတ်လို့ရပါတယ်။
#### Query
`select name,price from menu;`

ရိုးရိုး SELECT ကိုသုံးပြီး data ထုတ်ရာကနေ condition လေးတွေခံပြီးထုတ်ကြည့်ရအောင်။ `menu` table ထဲကမှ `category` က `Main Course` ဖြစ်တဲ့ item ကိုပဲလိုချင်တယ်ဆိုပါစို့။ `WHERE` ဆိုတဲ့ keyword ကိုသုံးပြီးဒီလိုဆွဲထုတ်လို့ရပါတယ်။
#### Schema
```
SELECT column1, column2, ...
FROM table_name
WHERE condition;
```
condition နေရာမှာ category က Main Course ပါဆိုတဲ့ category = 'Main Course' ကကိုအစားထိုးပေးလိုက်ပါမယ်ဆို Main Course ဖြစ်တဲ့ record တစ်ကြောင်းပဲထွက်လာတာကိုမြင်ရပါမယ်။
#### Query
```
SELECT * FROM menu WHERE category = 'Main Course';
```

သတိထားမိလားမသိဘူး၊ ကျနော် sql keywords တွေကို စာလုံးအသေးနဲ့ရောအကြီးနဲ့ရောသုံးသွားတယ်၊ နှစ်ခုလုံးအလုပ်လုပ်ပါတယ်။ သို့သော်ဖတ်ရလွယ်ကူရန်နဲ့ sql keywords တွေမှန်းသိသာအောင် capital letter ကိုသုံးတာကပိုပြီးသင့်တော်စေပါတယ်။
`menu` table ထဲကဈေး 10000 ထက်နည်းတဲ့ items တွေကိုဆွဲထုတ်ကြည့်ရအောင်။ `<` less than character ကိုအသုံးပြုပါမယ်။
#### Query
```
SELECT * FROM menu WHERE price < 10000;
```
10000 ထက်နည်းတဲ့ items နှစ်ခုကိုတွေ့ရပါမယ်။

လောလောဆယ်တော့ဒီလောက်ထိပဲသွားထားပါမယ်။ နောက်ပိုင်း queries တွေဆက်ရေးကြပါဦးမယ်။ table ကို delete ပြန်ချကြည့်ရအောင်။
#### Schema
```
DROP TABLE table_name;
```
#### Query
table\_name မှာ `menu` ကိုအစားထိုးလိုက်ပါမယ်။
```
DROP TABLE menu;
```

Queries အကြောင်းနည်းနည်းတီးမိခေါက်မိရှိသွားပြီဆိုတော့ DDL, DQL, DML ဒီသုံးခုအကြောင်းကိုဆက်ရှင်းပေးသွားပါမယ်။ SQL queries ကိုအဓိကအားဖြင့်သုံးမျိုးခွဲခြားနိုင်ပါတယ်။
### Data Definition Language (DDL):
DDL ကတော့ database structure တွေကိုစီမံဖို့အတွက်အသုံးပြုတဲ့ query တွေကိုဆိုလိုခြင်းဖြစ်ပါတယ်။ data တွေကိုစီမံတာမဟုတ်ဘဲ database objects တွေကိုကိုင်တွယ်နိုင်ဖို့အတွက်အသုံးပြုတာဖြစ်ပါတယ်။
### Data Query Language (DQL):
DQL ကတော့ database ထဲက data တွေကိုဆွဲထုတ်ဖို့အတွက်အသုံးပြုတဲ့ query တွေကိုဆိုလိုခြင်းဖြစ်ပါတယ်။ များသောအားဖြင့် SELECT statements တွေဖြစ်ပါတယ်။
### Data Manipulation Language (DML):
DML ကတော့ database ထဲက data တွေကိုသိမ်းဆည်း၊ပြုပြင်၊ဖျက်ဆည်းခြင်း INSERT, UPDATE, DELETE လုပ်ဖို့အတွက်အသုံးပြုတဲ့ query တွေကိုဆိုလိုခြင်းဖြစ်ပါတယ်။
နောက်အပိုင်းတွေကစပြီး ဒီ categories သုံးခုကိုကျောရိုးထားပြီးတော့ query တွေလက်တွေ့ရေးသားပြီးလေ့လာသွားကြပါမယ်။
# Data Definition Language
Data Definition လို့ဆိုတဲ့အတိုင်း DDL သည် database ရဲ့ structure တွေကိုသတ်မှတ်တည်ဆောက်ခြင်း၊ ပြောင်းလဲခြင်းတွေပြုလုပ်တဲ့ query တွေအတွက်သတ်မှတ်ထားတဲ့ category ဖြစ်ပါတယ်။ Database တစ်ခုတည်ဆောက်တဲ့နေရာမှာအရေးပါတဲ့ table, column data structure တွေကိုစီမံခန့်ခွဲခြင်း၊ data integrity ကောင်းရန်အတွက် အခြားသောလိုအပ်တဲ့ စည်းမျဉ်းများကို define လုပ်ရန်အတွက်အသုံးပြုပါတယ်။ data integrity ကိုအဓိပ္ပါယ်ရှိပြီးမှန်ကန်တဲ့ dataတွေလို့အကြမ်းဖျင်းသတ်မှတ်နိုင်ပါတယ်။
DDL ကိုဝါကျတစ်ကြောင်းတည်းနဲ့နားလည်အောင်ပြောရမယ်ဆို Database တစ်ခုရုပ်လုံးပေါ်လာအောင် structure တွေသတ်မှတ်(define) လုပ်ပေးရတဲ့ query များဆိုပြီးပြောနိုင်မယ်ထင်တယ်။ ဒီအပိုင်းမှာတော့အရေးကြီးပြီးအသုံးများတဲ့ DDL queries တွေကိုလေ့လာသွားကြပါမယ်။
## CREATE DATABASE: Defining a New Database
စမ်းချင်တာတွေစမ်းဖို့အတွက် `ddl_test` ဆိုတဲ့ database တစ်လုံးအရင်တည်ဆောက်လိုက်ရအောင်။
```
CREATE DATABASE ddl_test;
```

## CREATE TABLE: Defining a New Table
အရှေ့အပိုင်းမှာကျနော်တို့တွေ့ခဲ့ပြီးသားဖြစ်ပါတယ်။ database ထဲမှာ table တစ်လုံးတည်ဆောက်ရန်အတွက်အသုံးပြုပါတယ်။ လိုအပ်တဲ့ column နာမည်၊ structure တို့ကို define လုပ်ပြီးတည်ဆောက်နိုင်ပါတယ်။
#### Schema:
```
CREATE TABLE table_name (
column_name data_type,
...,
constraint_definition
);
```
Students ဆိုတဲ့ table တစ်လုံးတည်ဆောက်ရအောင်။
#### Query
```
CREATE TABLE students(
student_id INT,
name VARCHAR(50),
age INT,
remark VARCHAR (50)
);
```
`SHOW TABLES;` နဲ့ပြန်ပြီးစစ်ကြည့်နိုင်ပါတယ်။

## ALTER TABLE: Modifying Table Structure
ရှိပြီးသား table ရဲ့ structure ကိုပြောင်းလဲ `ALTER TABLE` ဆိုတဲ့ command ကိုအသုံးပြုပါတယ်။ table ထဲကို column အသစ်ထည့်တာ၊ ရှိပြီးသား column name ကိုပြောင်းတာ၊ column ကိုဖျက်တာစသည်ဖြင့်လုပ်ဆောင်နိုင်ပါတယ်။
### Adding a new column (column အသစ်ထည့်ခြင်း)
#### Schema
```
ALTER TABLE table_name
ADD column_name data_type constraint_definition,
...;
```
#### Query
```
ALTER TABLE students
ADD nick_name VARCHAR(50);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

### Changing column name (column အမည်ပြောင်းခြင်း)
#### Schema
```
ALTER TABLE table_name
RENAME COLUMN old_column_name TO new_column_name;
```
#### Query
```
ALTER TABLE students
RENAME COLUMN name TO formal_name;
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

### Dropping a column (column ဖျက်ခြင်း)
#### Schema
```
ALTER TABLE table_name
DROP COLUMN column_name;
```
#### Query
```
ALTER TABLE students
DROP COLUMN remark;
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

## DROP TABLE: Removing a Table (Table ဖျက်ခြင်း)
Table တစ်လုံးကိုဖျက်ချင်တဲ့အချိန်မှာတော့ DROP TABLE command ကိုအသုံးပြုနိုင်ပါတယ်။ table ထဲမှာသိမ်းဆည်းထားတဲ့ data တွေပါဖျက်တာဖြစ်တဲ့အတွက် ဂရုပြုဖို့လိုအပ်ပါတယ်။
#### Schema
```
DROP TABLE table_name;
```
#### Query
```
DROP TABLE students;
```

## Constraints: Ensuring Data Integrity
Table column တွေသတ်မှတ်တဲ့အချိန် data integrity ရှိဖို့အတွက်အပြင် business logic အရ constraints ဆိုတာမျိုးတွေထည့်ပေးဖို့လိုအပ်တဲ့အချိန်တွေရှိပါတယ်။ constraints အကြောင်းကိုအောက်က query တွေကြည့်ပြီးဆက်လေ့လာသွားကြပါမယ်။
### PRIMARY KEY Constraint:
`PRIMARY KEY` ဆိုတဲ့ constraint ပေးလိုက်တဲ့ column ဟာ record တိုင်းမှာ unique (မထပ်စေရ) ဖြစ်ပြီးတော့ NULL မဖြစ်ရဘူးဆိုပြီး define လုပ်ခြင်းခံလိုက်ရပါတယ်။
Table ထဲမှာရှိတဲ့ column တစ်ခုကို primary key အဖြစ်သတ်မှတ်လိုက်မယ်ဆို အဲ့ဒီ column ဟာ record တိုင်းမှာ unique ဖြစ်သွားမယ် (duplicate value မရှိတော့ဘူးလို့ဆိုလိုခြင်း)၊ column value ကို null value အလွတ်ထည့်ပေးလို့မရတော့ပါဘူး။
#### Schema
```
CREATE TABLE table_name (
column_name data_type PRIMARY KEY,
...,
constraint_definition
);
```
`students` table ကိုအရင်ဖျက်ပါမယ်။ `students` table မှာ student\_id ကို Primary key constraint ထည့်ပြီးတော့ဆောက်ကြည့်ပါမယ်။
#### Query
```
CREATE TABLE students (
student_id INT PRIMARY KEY,
name VARCHAR(50),
age INT
);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

### FOREIGN KEY Constraint:
DDL အကြောင်းရေးရင်းနဲ့မို့ တစ်လက်စတည်း `FOREIGN KEY` အကြောင်းပါထည့်ရေးလိုက်တာပါ။ အခုဖတ်တဲ့အချိန်နားလည်ရခက်နိုင်ပေမယ့် relationships လုပ်ရတဲ့ query တွေလေ့လာတဲ့အချိန်မှာပိုနားလည်လာပါလိမ့်မယ်။ FK ဆိုတာကတော့ column တစ်ခုရဲ့ value ကိုသုံးပြီးတော့ table တစ်လုံးနဲ့တစ်လုံးချိတ်ဆက်တဲ့နေရာမှာအသုံးပြုပါတယ်။
`students` table အပြင် `clubs` ဆိုတဲ့နော် table တစ်ခု create လုပ်ရအောင်။ ကျောင်းသားတစ်ယောက်က book club, chess club စသည်ဖြင့် club တစ်ခုခုနဲ့ချိတ်ဆက်နိုင်တဲ့ဆိုတဲ့သဘောပေါ့ဗျာ။
```
CREATE TABLE clubs(
club_id INT PRIMARY KEY,
club_name VARCHAR(50)
);
```
`DROP TABLE students;` ပြီးရင်လက်ရှိ club\_id ဆိုတဲ့ column ထပ်ဖြည့်ပြီး students ပြန် create လုပ်ပါမယ်။ students table ထဲက club\_id ကို FK အဖြစ်သတ်မှတ်ပြီး clubs ဆိုတဲ့ table ရဲ့ primary key `club_id` ကိုလှမ်း reference လုပ်လိုက်ပါမယ်။
#### Schema
```
CREATE TABLE table_name (
column_name data_type,
...,
CONSTRAINT constraint_name FOREIGN KEY (column_name) REFERENCES referenced_table(referenced_column)
);
```
#### Query
```
CREATE TABLE students(
student_id INT PRIMARY KEY,
name VARCHAR(50),
age INT,
club_id INT,
CONSTRAINT fk_club FOREIGN KEY (club_id) REFERENCES clubs(club_id)
);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

ကိုယ်ဆောက်ခဲ့တဲ့ reference key ဝင်မဝင်ဆိုတာကို `SHOW CREATE TABLE` သုံးပြီးကြည့်ရင်ပိုမြင်နိုင်ပါတယ်။

### NOT NULL Constraint:
Column value ကို NULL အထည့်မခံစေချင်တဲ့အချိန်မှာတော့ NOT NULL constraint ကိုအသုံးပြုပါတယ်။
#### Schema
```
CREATE TABLE table_name (
column_name data_type NOT NULL,
...,
constraint_definition
);
```
`students` table ကိုပြန်ဖျက်ပြီး `name` column ကို `NOT NULL` သုံးပြီးပြန်တည်ဆောက်ကြည့်ရအောင်။ ကျနော် `students` table ကိုပြန်ဖျက်ပြီးသုံးနေရတာက လောလောဆယ်မှာ table, column နာမည်တွေနဲ့မရှုပ်သွားစေချင်တာရယ်၊ `ALTER` command သုံးပြီးလုပ်လို့ရပေမယ့်လိုက်လုပ်ရတာခက်သွားမှာစိုးရိမ်မိလို့ပါ။
#### Query
```
CREATE TABLE students(
student_id INT PRIMARY KEY,
name VARCHAR(50) NOT NULL,
age INT NOT NULL
);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

### DEFAULT Constraint:
Data insert လုပ်တဲ့အချိန်မှာ NULL value ပါလာတဲ့အခါအစားထိုးအနေနဲ့သွင်းဖို့ default value တစ်ခုခု define လုပ်တဲ့နေရာမှာအသုံးပြုပါတယ်။
#### Schema
```
CREATE TABLE table_name (
column_name data_type DEFAULT default_value,
...,
constraint_definition
);
```
Students table ကိုပြန်ဖျက်ပြီး age column ကို DEFAULT သုံးပြီးပြန်တည်ဆောက်ကြည့်ရအောင်။ age value က null ဖြစ်ပြီဆို 14 ကို default အနေနဲ့ထည့်ပေးမယ်ဆိုတဲ့သဘောပါ။
#### Query
```
CREATE TABLE students (
student_id INT PRIMARY KEY,
name VARCHAR(50),
age INT DEFAULT 14
);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

### UNIQUE Constraint:
Table ထဲမှာပါတဲ့ columns တွေထဲမှာမှ unique ဖြစ်စေချင်တဲ့ column ရှိတဲ့အခါမှာအသုံးပြုပါတယ်။
#### Schema
```
CREATE TABLE table_name (
column_name data_type UNIQUE,
...,
constraint_definition
);
```
Students table ကိုဖျက်ပြီးတော့ name column ကို unique constraint ပေးပြီးပြန် create လုပ်ကြည့်ပါမယ်။
#### Query
```
CREATE TABLE students(
student_id INT PRIMARY KEY,
name VARCHAR(50) UNIQUE,
age INT
);
```
`DESCRIBE` keyword ကိုသုံးပြီးပြန်စစ်ကြည့်နိုင်ပါတယ်။

အသုံးများတဲ့ DDL queries တွေဖော်ပြပေးခဲ့တာဖြစ်ပါတယ်။ တိကျသေချာတဲ့ database schema တစ်ခုထွက်လာအောင်တည်ဆောက်တဲ့နေရာမှာ DDL ကိုကျွမ်းကျင်ဖို့က အလွန်အရေးပါပါတယ်။ နောက်အပိုင်းမှာ DQL အကြောင်းကိုဆက်လေ့လာသွားကြပါမယ်။
# Data Query Language
Database ထဲက data တွေကိုဆွဲထုတ်လိုတဲ့အချိန်မှာ DQLလို့ခေါ်တဲ့ query တွေကိုအသုံးပြုပါတယ်။ `SELECT` ကိုအသုံးပြုပြီး အနောက်မှာ condition အခြေအနေအမျိုးမျိုးလိုက်ကာ data တွေကို filter လုပ်နိုင်ဖို့အတွက် `WHERE` ဆိုတဲ့ keyword ကိုသုံးပါတယ်။ ဒီအပိုင်းမှာတော့ DQL ကိုပေါ်လွင်အောင်ရိုးရှင်းတဲ့နမူနာ queries တွေနဲ့အတူလေ့လာသွားကြပါမယ်။
MySQL command line client ကိုဖွင့်ပြီးတော့ DQL queries တွေစမ်းရေးကြည့်ဖို့အတွက် database အသစ်တစ်ခုဆောက်ရအောင်။
`CREATE DATABASE dql_test;` ဆောက်ပီးရင်သုံးဖို့အတွက် ready ဖြစ်အောင် `use dql_test;` ဆိုပြီးလုပ်ပေးထားလိုက်ပါမယ်။
## 
DQL queries တွေစမ်းဖို့အတွက် `products` ဆိုတဲ့ table တစ်ခုဆောက်ပါမယ်။
```
CREATE TABLE products (
product_id INT PRIMARY KEY,
product_name VARCHAR(255),
category VARCHAR(50),
price DECIMAL(10, 2),
stock_quantity INT,
supplier VARCHAR(100)
);
```
## 
Table ဆောက်ပြီးပြီးဆိုတော့ dummy data တစ်ချို့ထည့်သွင်းပါမယ်။ `INSERT` statement ကိုသုံးပါမယ်။
```
INSERT INTO products VALUES
(1, 'Laptop', 'Electronics', 899.99, 25, 'TechCorp'),
(2, 'Smartphone', 'Electronics', 599.99, 50, 'GadgetZone'),
(3, 'T-shirt', 'Clothing', 19.99, 100, 'FashionRUs'),
(4, 'Desk', 'Furniture', 149.99, 15, 'HomeFurnish'),
(5, 'Headphones', 'Electronics', 89.99, 75, 'AudioTech'),
(6, 'Shoes', 'Footwear', 59.99, 40, NULL),
(7, 'Backpack', 'Accessories', 39.99, 30, 'GearUp'),
(8, 'Watch', 'Accessories', 129.99, 10, 'TimePieces');
```
## 
DQL ဖြစ်တဲ့အတွက်ဒီအပိုင်းမှာ `SELECT` နဲ့ `WHERE` keyword ကိုအဓိကသုံးသွားမှာဖြစ်ပြီးတော့ query schema ကတော့အောက်ပါအတိုင်းဖြစ်ပါတယ်။
```
SELECT column1, column2, ...
FROM products
WHERE condition;
```
Condition နေရာမှာတော့လိုအပ်သလိုပုံစံမျိုးစုံလိုက်နိုင်ပါတယ်။ အောက်ကနမူနာတွေမှာဆက်ဖော်ပြပေးထားပါတယ်။
### Equal
ပထမဦးဆုံး products table ထဲကနေ `category` column က `Electronics` ဖြစ်တဲ့ value ကိုဆွဲထုတ်ကြည့်ပါမယ်။ column value အားလုံးလိုချင်တဲ့အတွက် \* ကိုသုံးပါမယ်။
```
SELECT *
FROM products
WHERE category = 'Electronics';
```
တူညီတဲ့ value ကိုလိုချင်တဲ့အတွက် `=` sign ကိုအသုံးပြုပါတယ်။
## 
### Greater than
ဈေးနှုန်း price column ကို 100 ကျော်တဲ့ records တွေကိုဆွဲထုတ်ကြည့်ပါမယ်။ `*` မသုံးဘဲနဲ့လိုချင်တဲ့ column တွေကိုပဲ comma နဲ့ဖြတ်ပြီးသတ်မှတ်ပေးလိုက်ပါမယ်။
```
SELECT product_name, price
FROM products
WHERE price > 100;
```
100`ကျော်`တဲ့ records ဆိုတဲ့အတွက် `>` sign ကိုအသုံးပြုပါတယ်။ အောက်ရောက်တယ်ဆိုရင် `<` less than sign ကိုသုံးပါမယ်။\
အားလုံးသိပြီးထားတဲ့ sign တွေအတိုင်းပါပဲ\
less than and equal ဆို `≤`\
greater than and equal ဆို `≥` အသုံးပြုပါတယ်။
## 
### AND
ဒီတစ်ခါ `AND` ဆိုတဲ့ keyword ကိုသုံးပြီး condition နှစ်ခု combine လုပ်ကြည့်ပါမယ်။ လွယ်ကူပါတယ်၊ condition နှစ်ခုကြားမှာအောက်ကလို `AND` ဆိုပြီးခံပေးလိုက်ရုံပါပဲ။\
condition ကတော့ stock\_quantity column ကို 50 အောက်ရောက်နေပြီးတော့ ဈေးနှုန်းက 20 ထက်ကြီးတဲ့ records တွေကိုဆွဲထုတ်ပါမယ်။
```
SELECT product_name, stock_quantity, price
FROM products
WHERE stock_quantity < 50 AND price > 20;
```
## 
### % (Find)
ဒီတစ်ခါတော့ `product_name` မှာ `Smart` ဆိုတဲ့ value ပါတဲ့ records တွေကိုဆွဲထုတ်ပါမယ်။\
keyword နဲ့တိုက်ပီးရှာချင်တယ်ဆိုရင် `%` sign ကိုအသုံးပြုပါတယ်။
```
SELECT product_name, category
FROM products
WHERE product_name LIKE '%Smart%';
```
`WHERE column_name LIKE 'abc%'`\
% sign ကနောက်မှာ value ကရှေ့မှာဆို abc နဲ့စတဲ့ values ရှာမယ်။\
`WHERE column_name LIKE '%a'`\
% sign ကရှေ့မှာ value ကနောက်မှာဆို abc နဲ့ဆုံးတဲ့ values ရှာမယ်။\
`WHERE column_name LIKE '%abc%'`\
% sign ကိုရှေ့နောက်နှစ်ခုလုံးကပ်ထားမယ်ဆိုနေရာမရွေးဘဲရှာမယ်။
## 
### NULL
`supplier` တန်ဖိုးက `NULL` ဖြစ်နေ (မရှိနေ)တဲ့ records တွေကိုဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT product_name, supplier
FROM products
WHERE supplier IS NULL;
```
## 
### BETWEEN AND
Range တန်ဖိုးတွေဆက်ဆွဲထုတ်ကြည့်ရအောင်၊ ဘယ်တန်ဖိုးကနေ ဘယ်တန်ဖိုးအထိဆိုတာမျိုးပေါ့။
`WHERE` နောက်မှာ `BETWEEN` နဲ့ `AND` keyword ကိုလိုက်ပြီးအသုံးပြုနိုင်ပါတယ်။\
`BETWEEN` နောက်မှာအစတန်ဖိုး၊ `AND` နောက်မှာအဆုံးတန်ဖိုးထည့်ပါမယ်။
```
SELECT product_name, price
FROM products
WHERE price BETWEEN 50 AND 100;
```
## 
### IN
အပေါ်မှာတုန်းကတူတဲ့ value ဆိုချင်ရင် `=` ဆိုတဲ့ sign ကိုအသုံးပြုခဲ့တယ်။\
`=` က value တစ်ခုပဲ assign လုပ်ချင်ပေမယ့် value တစ်ခုထက်ပိုပြီးထည့်သုံးချင်တဲ့အခါ `IN` ဆိုတဲ့ keyword ကိုပြောင်းသုံးရပါမယ်။
`category` column က `Clothing` ဒါမှမဟုတ် `Accessories` ဖြစ်တဲ့ records တွေကိုဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT product_name, category
FROM products
WHERE category IN ('Clothing', 'Accessories');
```
## 
### NOT IN
`IN` ရဲ့ပြောင်းပြန် `NOT IN` ကိုသုံးလိုက်မယ်ဆိုရင်တော့အဲ့ဒီ value တွေမပါတဲ့ records တွေကိုဆွဲထုတ်ပေးပါလိမ့်မယ်။ အောက်က screenshot မှာ result ကိုကြည့်နိုင်ပါတယ်။
## 
### NOT
value ကတစ်ခုတည်းဆိုရင်တော့ `NOT IN` ကိုမသုံးဘဲ `NOT` ဆိုတဲ့ keyword တစ်ခုတည်းနဲ့လည်းအသုံးပြုနိုင်ပါတယ်။\
အောက်မှာဆိုရင် `category` က `Furniture` မဟုတ်တဲ့ records တွေကိုဆွဲထုတ်ထားတာဖြစ်ပါတယ်။
```
SELECT product_name, category
FROM products
WHERE NOT category = 'Furniture';
```
## 
DQL ရဲ့သဘောက data တွေကိုမိမိလိုချင်သလိုဆွဲထုတ်နိုင်ဖို့ပါပဲ၊ ဒီလိုဆွဲထုတ်ဖို့အတွက် SELECT နဲ့ WHERE ကဘယ်လောက်ထိအရေးပါလဲဆိုတာအထက်က queries တွေကိုကြည့်ရင်မြင်နိုင်ပါတယ်။\
အခု article မှာတော့ DQL သဘောပေါ်လွင်အောင် ရိုးရှင်းတဲ့ query တွေကိုပဲအသုံးပြုထားပါသေးတယ်။\
နောက်ပိုင်းမှာ advance ဖြစ်တဲ့ query တွေနဲ့ data ဆွဲထုတ်ပုံတွေကိုလည်းဆက်လက်ရေးသားပေးပါမယ်။
# Data Manipulation Language
Database ထဲမှာရှိတဲ့ data တွေကိုလိုသလိုပြင်ဆင်ဖို့အတွက်(Manipulationလုပ်ဖို့အတွက်)အသုံးပြုပါတယ်။ DML queries တွေမှာ အဓိကအားဖြင့် SELECT, INSERT, UPDATE, DELETE keyword တွေကိုတွေ့ရမှာဖြစ်ပါတယ်။
SELECT နဲ့ INSERT query ကိုတော့ရှေ့အပိုင်းတွေမှာလည်းတွေ့ပြီးသားဖြစ်တဲ့အတွက် ဒီအပိုင်းမှာတော့ UPDATE, DELETE queries တွေကိုအာရုံစိုက်ပြီးကြည့်သွားကြပါမယ်။
## INSERT
အရှေ့အပိုင်းမှာသုံးခဲ့တဲ့ `products` table ကိုဆက်သုံးကြရအောင်။\
`select` အရင်ဆွဲကြည့်မယ်၊ records 8ကြောင်းရှိတာကိုတွေ့ပါမယ်၊ INSERT query ပြန်နွေးတဲ့အနေနဲ့ တစ်ကြောင်းထပ်ထည့်ကြည့်ပါမယ်။
`INSERT INTO products VALUES(9, 'Tablet', 'Electronics', 500, 50, 'SupplierA');`

***
## UPDATE
Table ထဲမှာရှိတဲ့ data တွေကို update လုပ်ကြပါမယ်။ `UPDATE` ဆိုတဲ့ command ကိုသုံးပါတယ်။
### Schema
```
UPDATE table_name
SET column_name = value
WHERE column_name = value;
```
Products table ထဲမှာရှိတဲ့ `product_name` က `Smartphone` ဖြစ်တဲ့ records တွေရဲ့ price တန်ဖိုးကိုပြင်ကြည့်ပါမယ်။ ဒါဆို query ကဒီလိုဖြစ်ပါမယ်။
```
UPDATE products
SET price = 649.99
WHERE product_name = 'Smartphone';
```
`select` နဲ့ပြန်ခေါ်ကြည့်မယ်ဆို `product_name` က `Smartphone` ဖြစ်တဲ့ record ရဲ့ `price` တန်ဖိုးပြောင်းသွားတာကိုမြင်နိုင်မှာဖြစ်ပါတယ်။\
`select` ဆွဲတဲ့နေရာမှာလေ့ကျင့်တဲ့အနေနဲ့ အောက်က screenshot ကိုမကြည့်သေးဘဲမိမိဘာသာစမ်းပြီးရေးကြည့်ဖို့တိုက်တွန်းချင်ပါတယ်။
Schema `select * from table_name where condition`
|  |
| --------------------------------------------------------------------------------------------------- |
| `product_name` က `Desk` ဖြစ်တဲ့ records တွေရဲ့ `stock_quantity` တန်ဖိုးကိုထပ်ပြီးပြင်ဆင်ကြည့်ပါမယ်။ |
```
UPDATE products
SET stock_quantity = 20
WHERE product_name = 'Desk';
```
ထုံးစံအတိုင်း update query ရဲ့ result ကို select query ပြန်ရေးပြီးကြည့်နိုင်ပါတယ်။

***
ဒီတစ်ခါတော့ value set လုပ်တဲ့နေရာမှာ calculation လုပ်ပြီးပြင်ဆင်ကြည့်ရအောင်။
`category` က `Electronics` ဖြစ်တဲ့ records တွေရဲ့ `stock_quantity` တန်ဖိုးကို မူလရှိရင်းစွဲတန်ဖိုးထက် ၁၀ခုပေါင်းထည့်ချင်တယ်ဆိုပါစို့၊ ဒီလိုမျိုးရေးနိုင်ပါတယ်။
```
UPDATE products
SET stock_quantity = stock_quantity + 10
WHERE category = 'Electronics';
```
အလားတူအခြားသော ပေါင်း၊နုတ်၊မြောက်၊စား signs တွေလည်းသုံးနိုင်ပါတယ်။

***
အောက်က example မှာတော့ multiplication sign ကိုသုံးပြထားပါတယ်။\
`category` က `Clothing` ဖြစ်တဲ့ records တွေရဲ့ `price` ကိုနှစ်ဆတင်ပြထားပါတယ်။
```
UPDATE products
SET price = price * 2
WHERE category = 'Clothing';
```

***
## DELETE
### Schema
```
DELETE FROM table_name WHERE condition;
```
`product_name` က `Shoes` ဖြစ်တဲ့ records တွေကိုဖျက်ချပါမယ်။\
ဒါဆို query ကဒီလိုဖြစ်ပါမယ်။
```
DELETE FROM products
WHERE product_name = 'Shoes';
```
ပျက်သွားလားဆိုတာကို select ပြန်ဆွဲပြီးကြည့်နိုင်ပါတယ်။ Delete ချတဲ့နေရာမှာ WHERE condition မလိုက်လို့လည်းရပါတယ်။\
မလိုက်ဘူးဆိုရင်တော့ table ထဲမှာရှိတဲ့ data တွေအကုန်ပျက်သွားမှာဖြစ်ပါတယ်။

***
အရှေ့မှာ example တွေပြခဲ့တဲ့အတိုင်း WHERE condition တွေနောက်မှာ filter လုပ်တဲ့ signs တွေလိုက်နိုင်ပါတယ်(=, <, > etc.)။\
DELETE query တွေမှာလည်းဒီလို filter တွေလုပ်ပြီးသုံးနိုင်ပါတယ်။
`stock_quantity` 30 အောက်ရောက်နေတဲ့ records တွေဖျက်ချင်တယ်ဆိုပါစို့။
```
DELETE FROM products
WHERE stock_quantity < 10;
```

အရှေ့က DQL မှာရေးခဲ့တဲ့ `NULL`, `NOT NULL` ဒီလို filter တွေခံပြီးတော့လည်းသုံးနိုင်ပါတယ်။ ဥပမာ `supplier` တန်ဖိုးက `NULL` ဖြစ်နေတဲ့ records တွေကိုဖျက်ချင်တယ်ဆို
```
DELETE FROM products
WHERE supplier IS NULL;
```
DML ရဲ့ကြောရိုးက ဒီ command ၄ခုပဲဖြစ်ပါတယ်။ သဘောတရားကိုအရင်နားလည်စေချင်တဲ့အတွက်ရိုးရှင်းတဲ့ example queries တွေနဲ့ပဲရေးပြပေးထားပါတယ်။
DDL, DQL, DML ရဲ့သဘောတရားကိုနားလည်သွားပြီဆိုနောက်အပိုင်းတွေမှာပိုပြီး advanced ဖြစ်တဲ့ queries ကိုလေ့လာသွားကြပါမယ်။
advanced ဖြစ်တဲ့ queries လို့ဆိုပေမယ့်လည်းလေ့လာခဲ့တဲ့ DDL, DQL, DML ဆိုတဲ့ category သုံးခုပေါ်မှာပဲ based လုပ်သွားမှာဖြစ်တဲ့အတွက်လေ့လာရလွယ်ကူမှာဖြစ်ပါတယ်။
# Let's get our hands dirty
# Sorting & Filtering
ဒီအပိုင်းမှာတော့ db ထဲက data တွေကို sorting စီတာတွေနဲ့ လိုအပ်တဲ့ data ကိုပဲသီးသန့်ဆွဲထုတ်တဲ့ `filtering` queries တွေကိုလေ့လာသွားကြပါမယ်။
`sql_test` ဆိုတဲ့ database ထဲမှာ `students` table တစ်လုံးဆောက်ထားလိုက်ပြီး `INSERT` command နဲ့ data တစ်ချို့ထည့်သွင်းထားပါမယ်။ ဒီ students table ကိုအသုံးပြုပြီး sorting နဲ့ filtering လုပ်တဲ့ queries တွေစမ်းသပ်သွားပါမယ်။

***
```
CREATE TABLE students (
student_id INT PRIMARY KEY,
name VARCHAR(50),
nick_name VARCHAR(50),
age INT,
major VARCHAR(50)
);
```
```
INSERT INTO students (student_id, name, nick_name, age, major)
VALUES
(1, 'John Doe', 'JD', 20, 'Computer Science'),
(2, 'Jane Smith', 'JS', 22, 'Mathematics'),
(3, 'Alice Johnson', 'AJ', 21, 'History'),
(4, 'Bob Williams', 'BW', 20, 'Chemistry'),
(5, 'Eva Brown', 'EB', 22, 'Biology'),
(6, 'Charlie Davis', 'CD', 21, 'Physics'),
(7, 'John Doe', 'JD', 20, 'Computer Science'),
(8, 'Alice Johnson', 'AJ', 21, 'History');
```
`select *` နဲ့ data တွေကိုပြန်စစ်ကြည့်နိုင်ပါတယ်။

***
### ORDER BY
Sorting စီဖို့အတွက် SQL မှာတော့ `ORDER BY` ဆိုတဲ့ command ကိုအသုံးပြုပါတယ်။ လိုအပ်သလို `ASC` ascending, `DESC` descending options တွေကိုအသုံးပြုနိုင်ပါတယ်။ `students` table ထဲက `name` တွေကို `ORDER BY` command အသုံးပြုပြီး `ASC`option နဲ့အစဉ်လိုက်စီကြည့်ပါမယ်။
```
SELECT * FROM students
ORDER BY name ASC;
```

***
`DESC` descending နဲ့စီမယ်ဆိုရင်တော့အခုရနေတဲ့ result `a to z` ကနေ `z to a` အဖြစ်ပြောင်းပြန်ရမှာဖြစ်ပါတယ်။
အသက် `age` column ကိုထောက်ပြီး `DESC` option နဲ့စီကြည့်ရအောင်၊ အသက်ကြီးဆုံးလူအရင်ပြဆိုတဲ့သဘောပေါ့။
```
SELECT * FROM students
ORDER BY age DESC;
```

***
`ASC` နဲ့စီမယ်ဆိုရင်တော့ထုံးစံအတိုင်းပြောင်းပြန် ပြန်ဖြစ်သွားပြီးတော့ အငယ်ဆုံး student ကိုအရင်ပြမှာဖြစ်ပါတယ်။
### DISTINCT
`select` ဆွဲတဲ့နေရာမှာ unique ဖြစ်တဲ့ record တွေပဲလိုချင်တဲ့အချိန်မှာ `DISTINCT` ဆိုတဲ့ keyword ကိုသုံးပါတယ်။ ဥပမာ `students` table ထဲက `major` နာမည်တွေလိုချင်တယ်၊ သို့ပေမယ့် ထပ်နေတဲ့ (duplicate) record တွေမပါချင်ဘူးဆိုတဲ့အခြေအနေမှာ `DISTINCT` ကိုသုံးနိုင်ပါတယ်
```
SELECT DISTINCT major FROM students;
```

***
### LIMIT
Table ထဲက records တွေအကုန်လုံးပါမလာချင်ဘူး၊ record ၂ခုပဲပါချင်တယ်၊ ၃ခုပဲပါချင်တယ်ဆိုတဲ့အခြေအနေမှာ `LIMIT` ခံပြီး select ဆွဲနိုင်ပါတယ်။
```
SELECT * FROM students LIMIT 2;
```

***
### OFFSET
select ဆွဲတဲ့နေရာမှာ records တစ်ချို့ကိုကျော်ပြီးဆွဲချင်တယ် သို့ စမှတ်ကိုပြောင်းပြီးသတ်မှတ်ချင်တယ်ဆိုရင် `OFFSET` ကိုသုံးနိုင်ပါတယ်။ query နဲ့ screenshot ကိုတွဲပြီးကြည့်မယ်ဆိုပိုသဘောပေါက်လွယ်ပါမယ်။ Records ၃ခုကိုကျော်ပြီး LIMIT ကို 2လို့ခံပြီးဆွဲမယ်ဆို result အဖြစ် 4 ကစမယ်၊ LIMIT 2 ဖြစ်တဲ့အတွက် 2 rows ပဲထုတ်သွားမှာဖြစ်ပါတယ်။
```
SELECT * FROM students LIMIT 2 OFFSET 3;
```

***
### Filtering
Filtering ကစိမ်းတဲ့အရာတစ်ခုတော့မဟုတ်ပါဘူး၊ အရှေ့က DQL အပိုင်းမှာ `WHERE` keyword ကိုသုံးပြီး query တွေဆွဲခဲ့ပါသေးတယ်။ Data တွေကို filter လုပ်တဲ့နေရာမှာ `WHERE` ကိုအသုံးပြုနိုင်ပါတယ်။ ဒီအပိုင်းမှာတော့ `WHERE` ကိုတစ်ချို့ commands လေးတွေပါ conjunction လုပ်ပြီးသုံးကြည့်ကြပါမယ်။
Computer Science `major` နဲ့ကျောင်းသားတွေကိုဆွဲထုတ်ကြည့်ရအောင်။
```
SELECT * FROM students
WHERE major = 'Computer Science';
```

***
### LIKE
LIKE ကိုလည်းအရှေ့မှာတစ်ခေါက်ပြောထားပြီးသားဖြစ်ပါတယ်။ search လုပ်မယ့်နေရာမှာသုံးပါတယ်။ နာမည်မှာ J နဲ့ စတဲ့ကျောင်းသားတွေကိုဆွဲထုတ်ကြည့်ချင်တယ်ဆိုပါစို့။
```
SELECT * FROM students
WHERE name LIKE 'J%';
```

***
### BETWEEN
Range condition တစ်ခုကြားထဲက data တွေကိုဆွဲထုတ်ချင်တဲ့အချိန်မှာသုံးပါတယ်။ ဥပမာ အသက် 20 နဲ့ 21 ကြားထဲကကျောင်းသားတွေကိုလိုချင်တယ်ဆိုပါစို့။
```
SELECT * FROM students
WHERE age BETWEEN 20 AND 21;
```

***
### Combining
အထက်မှာဖော်ပြခဲ့တဲ့ sorting နဲ့ filter commands တွေကိုပေါင်းပြီးအသုံးပြုကြည့်ပါမယ်။ အသက်ကို ငယ်စဉ်ကြီးလိုက်နဲ့ Biology major ဖြစ်တဲ့ကျောင်းသားတွေကိုဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT * FROM students
WHERE major = 'Biology'
ORDER BY age ASC;
```

***
အရှေ့အပိုင်းတွေမှာ WHERE ကို AND, OR ခံပြီးသုံးတာတွေရှိခဲ့ပါတယ်။ အခု query မှာ WHERE ကို နည်းနည်းပို advance ဖြစ်တဲ့နည်းနဲ့သုံးကြည့်ပါမယ်။
Table ထဲမှာ age 22 ဖြစ်တဲ့ကျောင်းသားကိုဆွဲမယ်၊ ပြီးတော့ကျောင်းသားက Computer Science သို့ Mathematics major ဖြစ်ရမယ်။ ဒီလိုမျိုး case မှာအောက်က query လိုမျိုး `( )` ရေးပေးခြင်းက conflict ဖြစ်နိုင်မယ့်အခြေအနေကိုကာကွယ်ပေးနိုင်ပါတယ်။
```
SELECT * FROM students
WHERE (major = 'Computer Science' OR major = 'Mathematics')
AND age = 22;
```

***
Sorting & filtering အပိုင်းမှာအသုံးများတဲ့ဥပမာတွေနဲ့တကွရေးသားပေးခဲ့ပါတယ်။ တစ်ချို့အရှေ့မှာပါပြီးသား commands တွေပြန်ပါတာတွေ့ရပါမယ်။ မျက်မှန်းတန်းမိသွားစေချင်တာအပြင် conjunction လုပ်ပြီးစမ်းသုံးကြည့်စေချင်ပါတယ်။ query တစ်ခုမှာ keyword ၃ ၄ ခုထည့်ပြီး select တွေဆွဲကြည့်ခြင်းဖြင့် နားလည်ထားတဲ့အရာတွေကိုပိုမို strong ဖြစ်လာစေတဲ့အပြင် real world queries တွေနဲ့လည်းပိုနီးစပ်လာနိုင်မှာဖြစ်ပါတယ်။
# Logical & Comparison Operators
ဒီ article မှာတော့ Operators တွေအကြောင်းကိုရေးသွားမှာဖြစ်ပါတယ်။ Logical and Comparison operators တွေကိုများသောအားဖြင့် data ဆွဲထုတ်တဲ့ queries တွေမှာအသုံးပြုကြပါတယ်။ Operators ဆိုလို့ထူးထူးဆန်းဆန်းတော့မဟုတ်ဘူး၊ အများစုကို အရှေ့ကအပိုင်းတွေမှာတွေ့ပြီးသားဖြစ်ပါတယ်၊ section တစ်ခုအနေနဲ့သီးသန့်ဖော်ပြချင်တဲ့အတွက်သာရေးလိုက်ခြင်းဖြစ်ပါတယ်။ Easy going ဖြစ်တဲ့အတွက် သိပြီးသား query တွေအတွက်ကျနော် screenshots တွေမထည့်ပေးထားပါဘူး။
## Logical Operators
### AND
`AND` keyword ကိုတော့တစ်ခုထက်ပိုတဲ့ conditions တွေကိုချိတ်ဆက်ပြီး data ဆွဲချင်တဲ့အချိန်မှာအသုံးပြုပါတယ်။ သုံးနေကျ `students` table က အသက် `20` ဖြစ်ပြီး `Computer Science` major ယူထားတဲ့ကျောင်းသားကိုထုတ်ကြည့်ရအောင်။
```
SELECT * FROM students
WHERE major = 'Computer Science'
AND age = 20;
```
### OR
`OR` ကတော့တစ်ခုထက်ပိုတဲ့ conditions တွေထဲကမှ တစ်ခုခုက valid ဖြစ်တယ်ဆိုရင် data ဆွဲထုတ်ချင်တဲ့နေရာမှာသုံးပါတယ်။ `students` table ထဲကနေ `major` က `Physics` `သို့မဟုတ် (OR)` `Mathematics` ဖြစ်တဲ့ကျောင်းသားတွေကိုဆွဲထုတ်ကြည့်ရအောင်။
```
SELECT * FROM students
WHERE major = 'Mathematics'
OR major = 'Physics';
```
### NOT
`NOT` ကိုတော့ ဒီ `condition` ကလွဲလို့ကျန်တဲ့ data ကအကုန်ပြပေးပါဆိုတဲ့အခြေအနေတွေမှာအသုံးပြုပါတယ်။ သိပ်မသုံးလောက်ဘူးထင်ရပေမယ့် အသုံးဝင်တဲ့ထဲမှာပါပါတယ်။ `students`table ထဲမှာ `Chemistry` major ကကျောင်းသားလွှဲလို့ကျန်တဲ့ကျောင်းသား data အကုန်ဆွဲထုတ်ချင်တယ်ဆိုပါစို့။
```
SELECT * FROM students
WHERE NOT major = 'Chemistry';
```
### LIKE
`%` sign ကိုအသုံးပြုပြီး pattern ကိုက်ညီတဲ့ data တွေကိုဆွဲထုတ်လိုတဲ့အချိန်မှာအသုံးပြုပါတယ်၊ Search လုပ်တယ်လို့လဲခေါ်နိုင်ပါတယ်။ % sign နဲ့ပတ်သတ်တဲ့ pattern အသေးစိတ်ကိုအရှေ့ပိုင်းတွေမှာပြောခဲ့ပါတယ်၊ မေ့နေရင်ပြန်ရှာဖတ်နိုင်ပါတယ်။
`students` table ထဲက `name` ဆိုတဲ့ column မှာ `John` ဆိုတဲ့စာသားပါတဲ့ data တွေကိုဆွဲထုတ်ချင်တယ်ဆိုပါစို့။
```
SELECT * FROM students
WHERE name LIKE '%John%';
```

***
### NOT LIKE
`LIKE` keyword ရဲ့ပြောင်းပြန်ပဲပေါ့။ LIKE ကကိုက်ညီတဲ့စာသားကိုပြတယ်၊ `NOT LIKE` ဆိုရင်တော့အဲ့ဒီ pattern (စာသား) မပါတဲ့ data တွေကိုပြမယ်။
`students` table ထဲမှာ `name` column က `Alice` ဆိုတဲ့စာသားမပါတဲ့ data တွေကိုလိုချင်တယ်ဆိုအောက်ကအတိုင်း `NOT LIKE` ကိုသုံးပြီးရေးနိုင်ပါတယ်။
```
SELECT * FROM students
WHERE name NOT LIKE '%Alice%';
```

***
## Comparison Operators
### Equal (=)
နှိုင်းယှဉ်ကြည့်ပြီး တူညီတဲ့တန်ဖိုးရှိတဲ့ data တွေကိုဆွဲထုတ်နိုင်ပါတယ်။ `students` table ထဲမှာ `age` ဆိုတဲ့ column က `21` ဖြစ်တဲ့ data တွေကိုလိုချင်တယ်ဆိုပါစို့။
```
SELECT * FROM students
WHERE age = 21;
```
### Not Equal (<>)
`Equal =` နဲ့ပြောင်းပြန်ဖြစ်သွားပါမယ်။ နှိုင်းယှဉ်ကြည့်ပြီးမတူညီတဲ့ data ပေါ့။ `students` table ထဲမှာ `major` column က `Physics` မဟုတ်တဲ့ data တွေကိုလိုချင်တယ်ဆိုအောက်ကအတိုင်းရေးနိုင်ပါတယ်။
```
SELECT * FROM students
WHERE major <> 'Physics';
```
### Greater Than (>), Less Than (<)
နှိုင်းယှဉ်ကြည့်ပြီး ကြီးသလား၊ ငယ်သလားဆိုတဲ့ condition ပေါ်မူတည်ပြီး data တွေဆွဲထုတ်နိုင်ပါတယ်။ `students` table ထဲမှာ `age` column ကို `22` ထက်ငယ်တဲ့ data တွေကိုလိုချင်တယ်။
```
SELECT * FROM students
WHERE age < 22;
```
`22`ထက်ကြီးတဲ့ data လိုချင်တယ်ဆိုရင်တော့ greater than `>` sign ကိုသုံးနိုင်ပါတယ်။
### Greater Than or Equal To (>=), Less Than or Equal To (<=)
ကြီးပြီးတော့တူတယ်၊ ငယ်ပြီးတော့တူတယ် ဆိုတဲ့ conditions တွေရှိတဲ့အချိန်မှာ `>=, <=` signs တွေကိုသုံးပါတယ်။
`students` table ထဲမှာ `age` column တန်ဖိုးက `20` ထက်ကြီးရမယ်၊ တူလည်းရတယ် ဆိုတဲ့အခြေအနေမှာအောက်က query လိုမျိုးအသုံးပြုနိုင်ပါတယ်။
```
SELECT * FROM students
WHERE age >= 20;
```

***
အထက်မှာဖော်ပြခဲ့တဲ့ Logical & comparison operators တွေဟာအခြေခံကျပြီး နေ့တဓူဝအသုံးပြုမယ့် queries တွေထဲပါဝင်ပါတယ်။ ရေးရတာလွယ်ကူပေမယ့် အသုံးဝင်တဲ့အရာတွေမို့လို့ သေချာလေးမိမိဘာသာထပ်ပြီးတော့လေ့ကျင့်ထားစေချင်ပါတယ်။
# Aggregations
Data တွေကိုစုပေါင်းပြီးတော့တွက်ချက်မှုတွေ၊ report ပုံစံမျိုးတွေထုတ်ပေးနိုင်ဖို့အတွက် SQL က Aggregations ဆိုတဲ့ functions တွေကို support လုပ်ပေးထားပါတယ်။ သဘောတရားကိုပိုနားလည်နိုင်ဖို့အတွက်အောက်က query တွေစမ်းရေးကြည့်ပြီး results တွေကိုကြည့်နိုင်ပါတယ်။
သုံးနေကျ `students` table ကိုပဲဆက်သုံးကြပါမယ်။
## COUNT
ထွက်လာမယ့် result set တစ်ခုရဲ့data rows တွေကိုတွက်ချင်တဲ့အချိန်မှာ COUNT ဆိုတဲ့ function ကိုသုံးနိုင်ပါတယ်။
```
SELECT COUNT(*) AS TotalStudents
FROM students;
```

***
COUNT(\*) ဆိုပြီး `*` ကိုသုံးပြီးတော့အားလုံးးရဲ့ results ကိုယူပါမယ်။ `AS TotalStudents` ဆိုတာကတော့ `alias` ပေးလိုက်တာဖြစ်ပါတယ်။ `alias` ဆိုတာကတော့အသုံးပြု (ပြန်ခေါ်လို့ရမယ့်)နာမည်တစ်ခုပေးလိုက်တာလို့ဆိုနိုင်ပါတယ်။ လောလောဆယ်သိပ်နားမလည်လည်းရပါတယ်။
`alias` မပါဘဲတန်းသုံးလည်းရပါတယ်။ ထွက်လာတဲ့ column နာမည်နေရာမှာတော့ `alias` နာမည်မဟုတ်တော့ဘဲ `COUNT(*)` ဆိုပြီးတော့ဘဲပါလာပါမယ်။ ဒါကြောင့်ပြန်ခေါ်သုံးရလွယ်အောင် နားလည်ရလွယ်ကူတဲ့ `alias` နာမည်လေးတွေပေးပြီး query ရေးလေ့ရှိကြပါတယ်။

***
## SUM
ကိန်းဂဏန်းတွေရှိတဲ့ column တွေရဲ့တန်ဖိုးတွေကိုစုပြီးပေါင်းချင်တဲ့အချိန်မှာ `SUM` ကိုသုံးနိုင်ပါတယ်။ ဥပမာ `students` table ထဲက `age` column တွေအကုန်ပေါင်းချင်တယ်ဆိုပါစို့၊ အောက်ကလိုမျိုး `SUM` ကိုသုံးပြီးရေးနိုင်ပါတယ်။
```
SELECT SUM(age) AS TotalAge
FROM students;
```

***
## AVG
AVG ကတော့ `SUM`နဲ့ပုံစံတူပဲ၊ သို့ပေမယ့်ပေါင်းတာမဟုတ်ဘဲနဲ့ Average ကိုတွက်ပေးတာဖြစ်ပါတယ်။ `students` table ထဲက `age` column ရဲ့ average ကိုတွက်ကြည့်ရအောင်။ (ဥပမာဒီကျောင်းကကျောင်းသားတွေရဲ့ average age ကဘယ်လောက်လဲဆိုတာမျိုးတွက်တဲ့နေရာမျိုးမှာအသုံးဝင်ပါတယ်။)
```
SELECT AVG(age) AS AverageAge
FROM students;
```

## MIN
`MIN` ကတော့အသေးဆုံးကိန်းဂဏန်းကိုဆွဲထုတ်ချင်တဲ့အချိန်မျိုးမှာသုံးပါတယ်။ `students` table ထဲကအသက်အငယ်ဆုံးကျောင်းသားကိုသိချင်တယ်ဆိုရင် ဒီလိုမျိုးထုတ်ကြည့်နိုင်ပါတယ်။
```
SELECT MIN(age) AS YoungestAge
FROM students;
```

***
## MAX
`MAX` ကတော့ `MIN` နဲ့ပြောင်းပြန်အကြီးဆုံးကိုဆွဲထုတ်တာဖြစ်ပါတယ်။
```
SELECT MAX(age) AS OldestAge
FROM students;
```

***
## GROUP BY
`GROUP BY` ကိုအရှေ့မှာတွေ့ပြီးသားဖြစ်မှာပါ။ ထပ်ဖော်ပြရတဲ့အကြောင်းရင်းက Aggregation function တွေသုံးပြီး query ဆွဲတဲ့အချိန်မှာ `GROUP BY` ကိုသုံးပြီး group လေးတွေခွဲပြီး data တွေကိုထုတ်ကြည့်လို့ရပါတယ်။ ဥပမာ `major` တစ်ခုချင်းစီမှာကျောင်းသားဘယ်နှစ်ယောက်ရှိလဲဆိုတာမျိုးသိချင်ရင် `GROUP BY` ကို Aggregation function တွေနဲ့ပေါင်းပြီးအောက်ကလိုသုံးနိုင်ပါတယ်။
```
SELECT major, COUNT(*) AS NumberOfStudents
FROM students
GROUP BY major;
```

***
## HAVING
`HAVING` ကတော့ အရှေ့အပိုင်းတွေမှာဖော်ပြခဲ့တဲ့ `WHERE` နဲ့အတူတူပါပဲ။ Aggregation functions တွေမှာ `WHERE` ကိုအသုံးပြုလို့မရနိုင်တဲ့အတွက် `HAVING` ကိုသုံးခြင်းဖြစ်ပါတယ်။ အပေါ်က query ကိုပဲ `HAVING` နဲ့ filter ခံကြည့်ရအောင်။ `major` group ထဲကမှကျောင်းသားတစ်ယောက်အထက်ရှိတဲ့ `major` ကိုပဲလိုချင်တယ်ဆိုပါစို့။
```
SELECT major, COUNT(*) AS NumberOfStudents
FROM students
GROUP BY major
HAVING COUNT(*) > 1;
```

***
Aggregation functions တွေက real world မှာလည်းအသုံးဝင်တဲ့ functions တွေဖြစ်ပါတယ်။ သူ့ချည်းပဲဆိုမသိသာပေမယ့် `GROUP BY` တို့ `HAVING` တို့ခံပြီးသုံးမယ်ဆိုအရမ်း powerful ဖြစ်တဲ့အပြင် query ကများတဲ့အခါရေးရတာလဲ နည်းနည်း tricky ဖြစ်တတ်ပါတယ်။ အပေါ်ကကျနော့်နမူနာကို စုတုပြုပြီး မိမိဘာသာဆက်ပြီးလေ့ကျင့်ကြည့်ကြပါဦး။
# DATE & TIME
ဒီအပိုင်းမှာတော့ date, time ရဲ့ data type အကြောင်းနဲ့အသုံးပြုပုံ functions တွေအကြောင်းကိုရေးသွားမှာဖြစ်ပါတယ်။
`DATE, TIME` data type အသစ်တွေကိုစမ်းမှာဖြစ်တဲ့အတွက်လက်ရှိရှိပြီးသား `students` table ကိုဖြုတ်ချပြီး table အသစ်ဆောက်လိုက်ပါမယ်။

column အသစ်သုံးခုထည့်ပါမယ်။ `birth_date` ကို `Date` `class_time` အတန်းထဲရှိတဲ့အချိန်ကို `TIME` `last_updated` လက်ရှိ record/row ကိုနောက်ဆုံးပြင်ဆင်ထားချိန်ကို `DATETIME` အဖြစ်သတ်မှတ်ပေးထားလိုက်ပါတယ်။ သုံးမျိုးလုံးကိုစမ်းပြပေးချင်လို့ပါ။
အောက်က `CREATE` query နဲ့ data ထည့်မယ့် `INSERT` query ကိုအသုံးပြုနိုင်ပါတယ်။
```
CREATE TABLE students (
student_id INT PRIMARY KEY,
name VARCHAR(50),
nick_name VARCHAR(50),
age INT,
major VARCHAR(50),
birth_date DATE,
class_time TIME,
last_updated DATETIME
);
```
```
INSERT INTO students (student_id, name, nick_name, age, major, birth_date, class_time, last_updated)
VALUES
(1, 'John Doe', 'JD', 20, 'Computer Science', '2000-05-15', '14:30:00', '2022-10-18 08:45:00'),
(2, 'Jane Smith', 'JS', 22, 'Mathematics', '1999-09-10', '10:45:00', '2021-08-25 15:20:00'),
(3, 'Alice Johnson', 'AJ', 21, 'History', '2002-03-01', '18:15:00', '2023-01-12 12:30:00'),
(4, 'Bob Williams', 'BW', 20, 'Chemistry', '2001-08-12', '08:00:00', '2022-05-07 20:10:00'),
(5, 'Eva Brown', 'EB', 22, 'Biology', '1999-12-05', '21:20:00', '2021-11-30 11:55:00'),
(6, 'Charlie Davis', 'CD', 21, 'Physics', '2000-06-20', '12:10:00', '2022-03-17 17:40:00'),
(7, 'John Doe', 'JD', 20, 'Computer Science', '2000-05-15', '14:30:00', '2022-10-18 08:45:00'), -- Duplicate name data
(8, 'Alice Johnson', 'AJ', 21, 'History', '2002-03-01', '18:15:00', '2023-01-12 12:30:00'); -- Duplicate name data
```

***
များသောအားဖြင့်ကျနော်တို့မြင်တွေ့ရမယ့် type ပုံစံတွေက DATE (နေ့စွဲ) TIME (အချိန်) DATETIME (နေ့စွဲ+အချိန်)
Format ကတော့ DATE ဆို (YYYY-MM-DD) TIME ဆို (HH:MI:SS) DATETIME ဆို (YYYY-MM-DD HH:MI:SS) ဆိုပြီးရှိပါတယ်။ ဒီ format အထားအသိုကိုလည်းလိုသလိုပြောင်းနိုင်ပါတယ်။
```
YYYY - year
MM - month
DD - date
HH - hour
MI - minute
SS- second
```
Keyword တွေကအသုံးပြုတဲ့ DBMS ပေါ်လိုက်ပြီးတော့ပြောင်းနိုင်တာကိုလည်းသတိချပ်ထားရပါတယ်။ အခုကျနော်တို့က MySQL ကိုသုံးနေတာဖြစ်ပါတယ်။
## NOW, CURRENT\_DATE, CURRENT\_TIMESTAMP
လက်ရှိအချိန်၊နေ့ရက်တွေကိုရချင်တယ်ဆို ဒီ function တွေကိုအောက်ကလိုအသုံးပြုနိုင်ပါတယ်။
```
SELECT NOW() AS CurrentDateAndTime;
```

***
```
SELECT CURRENT_DATE AS CurrentDate;
```

```
SELECT CURRENT_TIMESTAMP AS CurrentTimestamp;
```

***
## TIMESTAMPDIFF
အချိန်ကွာခြားချက်ကိုသိနိုင်ဖို့အတွက် `TIMESTAMPDIFF` ကိုအသုံးပြုနိုင်ပါတယ်။
ကျောင်းသားတွေရဲ့အသက်ကိုတွက်ကြည့်ရအောင်။ တွက်ဖို့ဆိုလက်ရှိအချိန်နဲ့ `birth_date` column ကိုတန်ဖိုးကွာခြားချက်ကို `YEAR` ဆိုတဲ့ filter နဲ့ချလိုက်မယ်ဆိုကျောင်းသားတွေရဲ့ လက်ရှိအသက်ရလာနိုင်ပါတယ်။ အောက်ကရေးပုံကိုကြည့်နိုင်ပါတယ်။
```
SELECT name, TIMESTAMPDIFF(YEAR, birth_date, CURDATE()) AS AgeInYears
FROM students;
```

***
ဒီတစ်ခါအသက်တွေကို YEAR နဲ့မဟုတ်ဘဲ MONTH နဲ့ကြည့်ရအောင်။ `YEAR` keyword အစား `MONTH` ဆိုတဲ့ keyword ကိုအစားထိုးအသုံးပြုနိုင်ပါတယ်။
```
SELECT name, TIMESTAMPDIFF(MONTH, birth_date, CURDATE()) AS AgeInMonths
FROM students;
```

***
## DATE\_ADD, DATE\_SUB
နေ့ရက်အချိန်တွေကိုပေါင်းခြင်း၊ နုတ်ခြင်းတို့လည်းလုပ်ဆောင်နိုင်ပါတယ်။ ပေါင်းတာနုတ်တာမြင်သာအောင် query မ run ခင်အရင် select \* နဲ့ အချိန်၊နေ့စွဲတွေကိုကြည့်ထားနိုင်ပါတယ်။
`last_updated` ဆိုတဲ့ column ရဲ့တန်ဖိုးကို အချိန် ၂ နှစ်ထည့်ပေါင်းကြည့်ရအောင်။
```
SELECT name, DATE_ADD(last_updated, INTERVAL 2 YEAR) AS NewLastUpdated
FROM students;
```

***
`class_time` column ရဲ့အချိန်တန်ဖိုးထဲကမိနစ်သုံးဆယ်နုတ်ကြည့်ရအောင်။
```
SELECT name, DATE_SUB(class_time, INTERVAL 30 MINUTE) AS NewClassTime
FROM students;
```

***
## EXTRACT
column ထဲက date time တန်ဖိုးထဲကမှကိုယ်လိုချင်တဲ့အပိုင်းကိုပဲထုတ်ယူလို့လည်းရပါတယ်။ ဥပမာ `YYYY-MM-HH` ထဲ က `YYYY` ကိုလည်းလိုချင်တယ်၊ `MM` ပဲလိုချင်တယ်ဆိုတဲ့အခြေအနေမျိုးတွေမှာ `EXTRACT`ကိုသုံးနိုင်ပါတယ်။
`birth_date` column ထဲကမှ `year` ကိုပဲဆွဲထုတ်ကြည့်ကြည့်ရအောင်။
```
SELECT name, EXTRACT(YEAR FROM birth_date) AS BirthYear
FROM students;
```

***
`class_time` column ထဲက `hour` ကိုပဲဆွဲထုတ်ကြည့်ရအောင်။
```
SELECT name, EXTRACT(HOUR FROM class_time) AS ClassHour
FROM students;
```

***
## DATE\_FORMAT
အရှေ့မှာ date, time format တွေကိုလိုသလိုပြောင်းလို့ရတယ်လို့ကျနော်ပြောခဲ့ပါတယ်။ `DATE_FORMAT` ဆိုတဲ့ function ကိုသုံးပြီးတော့ပြောင်းနိုင်ပါတယ်။
`birth_date` ကို format နောက်တစ်မျိုးဖြစ်တဲ့ `Month DD, YYYY` အဖြစ်ပြောင်းကြည့်ပါမယ်။
```
SELECT name, DATE_FORMAT(birth_date, '%M %d, %Y') AS FormattedBirthDate
FROM students;
```

***
`last_updated` ကိုလည်း `YYYY-MM-DD HH:MI AM/PM` အဖြစ်ပြောင်းကြည့်ပါမယ်။
```
SELECT name, DATE_FORMAT(last_updated, '%Y-%m-%d %h:%i %p') AS FormattedLastUpdated
FROM students;
```

***
`class_time` ကိုလည်း `HH:MI AM/PM` အဖြစ်ပြောင်းကြည့်ပါမယ်။
```
SELECT name, DATE_FORMAT(class_time, '%h:%i %p') AS FormattedClassTime
FROM students;
```

***
တစ်ခြားသော function တွေလည်းများစွာရှိပါသေးတယ်၊ ကျနော်လိုသလောက်ပဲထုတ်နုတ်ထားလိုက်တာပါ။အခုအပိုင်းကအရင်ရေးခဲ့တဲ့ queries တွေနဲ့မတူဘဲနည်းနည်းလေးခက်ကောင်းခက်နိုင်ပါတယ်။ function တွေအသုံးပြုတာပါလာတာရယ်၊ format လေးတွေပါလာတာရယ်ကြောင့်ပါ။ သို့ပေမယ့် များများလေ့ကျင့်လိုက်ရင်တော့ကျင့်သားရလာမှာပါ။
`DATE & TIME` data တွေကမရှိမဖြစ်ပါလေ့ရှိတာကြောင့် ကိုယ်လိုသလိုဆွဲထုတ်ချင်လာတဲ့အချိန်မှာအခုပြောခဲ့တဲ့အရာလေးတွေကအသုံးဝင်လာမယ်လို့ထင်ပါတယ်။
# Relationships
# Relationship
ဒီအပိုင်းမှာတော့ execute လုပ်တဲ့ screenshots တွေမပါသေးပါဘူး။ SQL ရဲ့ `relationship` အကြောင်းကိုပေါ်လွင်အောင်ရှင်းပြပေးပြီးတော့ နောက်အပိုင်းတွေမှာတစ်ခုခြင်းဆီကို နမူနာတွေနဲ့တကွ run ကြည့်သွားပါမယ်။
SQL မှာ `relationship` ဆိုတာက Tables တွေကိုချိတ်ဆက်ပြီးလိုအပ်သလို data တွေကိုဆွဲထုတ်ခြင်းကိုဆိုလိုပါတယ်။ Table တစ်လုံးခြင်းဆီတိုင်းက သီးသန့်ရပ်တည်နိုင်သလို တစ်လုံးနှင့်တစ်လုံး `ပတ်သက်ဆက်နွယ်ခြင်း` မျိုးတွေလည်းရှိနိုင်ပါတယ်၊ ဒီလိုပတ်သက်ဆက်နွယ်ခြင်းကို `relationship` အနေနဲ့သတ်မှတ်နိုင်ပြီး Table တစ်လုံးနဲ့တစ်လုံးဘယ်လိုချိတ်ဆက်နိုင်မလဲဆိုတာကို အောက်မှာဥပမာတွေပေးပြီးရှင်းပြပေးသွားပါမယ်။
## Primary Key
Primary Key ဆိုတာကတော့ Table တစ်လုံးမှာရှိတဲ့ unique identifier column ဖြစ်ပါတယ်။ `unique` ဖြစ်တယ်ဆိုတာ record (row) တိုင်းမှာပါတဲ့ အဲ့ဒီ column ရဲ့ value မှာ `ထပ်` နေခြင်းမရှိတာကိုဆိုလိုခြင်းဖြစ်ပါတယ်။
ဥပမာအောက်က `employees`ဆိုတဲ့ Table မှာ `employee_id` ဆိုတဲ့ column ဟာအမြဲတမ်း `unique` ဖြစ်နေနိုင်တဲ့အတွက် `PRIMARY KEY` အဖြစ်သတ်မှတ်ထားလို့ရပါတယ်။
```
CREATE Table employees (
employee_id INT PRIMARY KEY,
name VARCHAR(50),
department_id INT
);
```
ဒီ `PRIMARY KEY` ကို Table တွေ `relationship` ချိတ်ဆက်တဲ့နေရာမှာလည်းပြန်လည်အသုံးပြုပါတယ်။
## Foreign Keys
Foreign Key ဆိုတာကတော့တစ်ခြား Table တစ်လုံးက primary key ဖြစ်ပါတယ်။ Table နှစ်လုံးကိုချိတ်ဆက်တဲ့အခါအသုံးပြုတဲ့အရာပဲဖြစ်ပါတယ်။ Table B က Table A ကိုချိတ်ဆက်ချင်တယ်ဆို Table B ထဲမှာ Table A ရဲ့ primary key ကိုထည့်လိုက်ခြင်းဖြင့်ချိတ်ဆက်နိုင်ပါတယ်။ အောက်ကဥပမာကိုကြည့်လိုက်ရင်ပိုပြီးမြင်သွားလိုက်ပါမယ်။
```
CREATE Table departments (
department_id INT PRIMARY KEY,
department_name VARCHAR(50)
);
```
`departments` ဆိုတဲ့ Table တစ်လုံးရှိပါမယ်၊ `department_id` ကို `PRIMARY KEY` အဖြစ်သတ်မှတ်ထားပါတယ်။
```
CREATE Table employees (
employee_id INT PRIMARY KEY,
name VARCHAR(50),
department_id INT,
FOREIGN KEY (department_id) REFERENCES departments(department_id)
);
```
`employees` ဆိုတဲ့ Table ထဲမှာ `department_id` ထည့်ထားပြီး `FOREIGN KEY` အဖြစ်သတ်မှတ်လိုက်မယ်ဆို `employees` Table ကနေတစ်ဆင့် `departments` Table ထဲက data တွေကိုပါဆွဲထုတ်နိုင်သွားမှာဖြစ်ပါတယ်။ `department_id` က `departments` Table ထဲမှာတော့ `PRIMARY KEY` ဖြစ်ပေမယ့် `employees` Table ထဲမှာတော့ `FOREIGN KEY` အနေနဲ့ဖြစ်သွားပါတယ်။
```
FOREIGN KEY (department_id) REFERENCES departments(department_id)
```
ဒါကတော့ `FOREIGN KEY` အဖြစ်သတ်မှတ်ကြောင်းရေးတဲ့အပိုင်းဖြစ်ပါတယ်။ ဘယ် Table ကို `REFERENCES (link)` လုပ်မလဲဆိုတာကိုပါထည့်သွင်းပေးရပါမယ်။
## Types of Relationships
Relationship ရဲ့သဘောတရားကိုနားလည်သွားပြီဆိုတော့ relationship `type` အကြောင်းလေးတွေကိုဆက်ရှင်းပေးသွားပါမယ်။ Table တစ်လုံးနဲ့တစ်လုံးချိတ်ဆက်တဲ့အချိန်မှာ ချိတ်ဆက်နိုင်တဲ့ `အမျိုးအစား` တွေလို့လည်းဆိုနိုင်ပါတယ်။
### One To One Relationship
Table တစ်ခုနဲ့တစ်ခုဟာ `one to one` ပုံစံမျိုးနဲ့ပဲချိတ်ဆက်ထားတာကို one to one relationship လို့ခေါ်ပါတယ်။ ဥပမာအောက်ကနမူနာမှာဆို `students` Table နဲ့ `student_details` ဆိုတဲ့ Table နှစ်လုံးရှိပါတယ်။ `student` တစ်ယောက်ဟာ သူနဲ့ပတ်သတ်တဲ့ `detail` record တစ်ခုပဲရှိနိုင်ပါတယ်။ ဒါကြောင့်မို့ ဒီ Table နှစ်လုံးရဲ့ relationship ပုံစံဟာ `one to one` ဖြစ်ပါတယ်။
```
CREATE Table students (
student_id INT PRIMARY KEY,
name VARCHAR(50)
);
```
```
CREATE Table student_details (
student_id INT PRIMARY KEY,
address VARCHAR(100),
FOREIGN KEY (student_id) REFERENCES students(student_id)
);
```
### One To Many Relationship
Tableတစ်လုံးက record သည် နောက် Table တစ်လုံးမှာ တစ်ခုထက်ပိုသော records တွေအဖြစ်ချိတ်ဆက်နိုင်ခြေရှိတယ်ဆို `one to many` relationship ပုံစံမျိုးဖြစ်နိုင်ပါတယ်။
ဥပမာအောက်ကနမူနာမှာဆို `author` Table တစ်လုံးရှိပါမယ်။ `author` တစ်ယောက်ကစာအုပ်တွေတစ်အုပ်ထက်ပိုပြီးရေးနိုင်ပါတယ်။ ဒါကြောင့် `books` Table မှာ `author_id` ကို foreign key အဖြစ်ထားပြီး `one to many` relationship ပုံစံမျိုးချိတ်ဆက်နိုင်ပါတယ်။ `authors` -> one , `books` -> many ဖြစ်သွားပါမယ်။
ဒီလိုချိတ်ဆက်လိုက်ခြင်းအားဖြင့် `books` Table ထဲက records တွေကိုဆွဲထုတ်တဲ့အချိန်မှာ အဲ့ဒီ book record ရဲ့ `author` information တွေကိုတစ်ပါတည်းဆွဲနိုင်မှာဖြစ်ပါတယ်။
```
CREATE Table authors (
author_id INT PRIMARY KEY,
name VARCHAR(50)
);
```
```
CREATE Table books (
book_id INT PRIMARY KEY,
title VARCHAR(100),
author_id INT,
FOREIGN KEY (author_id) REFERENCES authors(author_id)
);
```
### Many To Many Relationship
Table နှစ်လုံးလုံးဟာအခြင်းခြင်း တစ်ခုထက်ပိုတဲ့ records တွေအပြန်အလှန်ရှိနိုင်ခြေရှိတယ်ဆို `many to many` relationship ပုံစံမျိုးဖြစ်သွားနိုင်ပါတယ်။ ဒီလိုအခြေအနေမှာတော့ကြည့်ရတာပိုပြီးရှင်းလင်းအောင် ကြားခံ Table တစ်လုံးဆောက်လေ့ရှိကြပါတယ်။ Table နှစ်လုံးကို ကြားခံဆက်သွယ်ပေးတဲ့ပုံစံဖြစ်ပါတယ်။ `junction` Table, `associative` Table လို့လည်းခေါ်ကြပါတယ်။
အောက်ကနမူနာကိုကြည့်မယ်ဆို `students` Table နဲ့ `courses` Table ကိုမြင်ရပါမယ်။ student တစ်ယောက်ဟာ course တွေအများကြီးရှိနိုင်သလို course တစ်ခုမှာလည်း student တွေအများကြီးတက်ရောက်နေတာမျိုးရှိပါတယ်။ ဒီလိုအခြေအနေကို `many to many` လို့ခေါ်ဆိုနိုင်ပြီး ဒီနှစ်ခုကိုလွယ်ကူစွာချိတ်ဆက်နိုင်ရန်အတွက် `student_courses` ဆိုပြီးကြားခံ `junction` Table တစ်ခုဆောက်နိုင်ပါတယ်။ Junction Table ထဲမှာ `students` Table နဲ့ `courses` Table ကို reference လုပ်နိုင်တဲ့ `FOREIGN KEYS` တွေထည့်လိုက်ရုံပါပဲ။
```
CREATE Table students (
student_id INT PRIMARY KEY,
name VARCHAR(50)
);
```
```
CREATE Table courses (
course_id INT PRIMARY KEY,
course_name VARCHAR(100)
);
```
```
CREATE Table student_courses (
student_course_id INT PRIMARY KEY,
student_id INT,
course_id INT,
FOREIGN KEY (student_id) REFERENCES students(student_id),
FOREIGN KEY (course_id) REFERENCES courses(course_id)
);
```
ဒီအပိုင်းမှာ relationship ဆိုတာကို theoretically အရ နားလည်ရလွယ်ကူအောင်အရင်ရှင်းပြပေးခဲ့ပါတယ်။ relationship ဆိုတာဘာလဲ၊ ဘယ်လိုမျိုးချိတ်ဆက်နိုင်တယ်၊ ဘယ်လို relationship အမျိုးအစားတွေရှိမယ်ဆိုတာတွေကိုရေးခဲ့ပါတယ်။ လက်တွေ့ query တွေကို execute မလုပ်ရသေးတဲ့အတွက်နည်းနည်းနားလည်ရခက်နိုင်ပေမယ့် နောက်အပိုင်းတွေမှာ relationship အမျိုးအစားတွေကို တစ်ခုခြင်းဆီအသေးစိတ်ပြန်ရေးရင်း query တွေ run ကြည့်သွားမှာဖြစ့်တဲ့အတွက် ပိုပြီးနားလည်သွားမယ်လို့ထင်ပါတယ်။
# Joins
Relationship အပိုင်းမှာ table တွေကိုချိတ်ဆက်ပြီး data တွေယူတယ်လို့ပြောခဲ့ပါတယ်။ ဒီလိုချိတ်ဆက်ဖို့အတွက် `JOIN` ဆိုတဲ့ keyword ကိုသုံးပြီး query တွေရေးပါတယ်။ အခုအပိုင်းမှာတော့ အသုံးများတဲ့ JOIN အမျိုးအစားတွေကိုရှင်းပြရင်း JOIN အသုံးပြုနည်းကိုပါ query တွေ run ကြည့်သွားရင်းလေ့လာသွားကြပါမယ်။
ဒါကတော့ JOIN query ရဲ့ schema ပဲဖြစ်ပါတယ်။
```
SELECT column1, column2, ...
FROM table1
INNER JOIN table2 ON table1.column_name = table2.column_name;
```
`ON table1.column_name = table2.column_name` ဆိုတာကတော့ table နှစ်လုံးရဲ့ `primary key`, `foreign key` ကိုချိတ်ဆက်မယ့် condition တစ်ခုကိုဖော်ပြတဲ့သဘောဖြစ်ပါတယ်။
`INNER JOIN` ဆိုတာကတော့အဲ့ဒီ `condition` အပေါ်မှာ match ဖြစ်တဲ့ records သီးသန့်ကိုပဲလိုချင်တယ်လို့ဆိုတာပါ။ `INNER JOIN` က JOIN အမျိုးအစားတစ်ခုပဲဖြစ်ပါတယ်။
အောက်မှာတစ်ခြားသော `JOIN` တွေကိုဆက်ကြည့်ရင်း JOIN queries တွေကိုပိုသဘောပေါက်အောင်ကြိုးစားကြည့်ပါမယ်။
Join query တွေမရေးခင်မှာ tables တွေနဲ့ data တွေပြင်ဆင်ထားပါမယ်။
ရှိပြီးသား `students`table နဲ့ `student_details` ဆိုတဲ့ table နှစ်ခုကိုသုံးပြီးတော့ JOIN queries တွေစမ်းရေးသွားပါမယ်။
`student_details` table ဆောက်ပါမယ်၊ ရှိပြီးသားသူတွေကတော့ဆောက်စရာမလိုပါဘူး။
```
CREATE TABLE student_details (
student_id INT PRIMARY KEY,
address VARCHAR(100),
FOREIGN KEY (student_id) REFERENCES students(student_id)
);
```
တစ်ခါတည်း student\_id ကို `students` table ရဲ့ foreign key အဖြစ်သတ်မှတ်ထားလိုက်ပါတယ်။
`student_details`table ထဲကို data ထည့်ပါမယ်။
```
INSERT INTO student_details (student_id, address) VALUES
(1, 'Yangon, Myanmar'),
(2, 'Mandalay, Myanmar'),
(3, 'Naypyidaw, Myanmar'),
(4, 'Bago, Myanmar'),
(5, 'Magway, Myanmar');
```

## Inner Join
Inner Join ဆိုတာကတော့ table နှစ်လုံးထဲကမှ သတ်မှတ်လိုက်တဲ့ **condition** ပေါ်မူတည်ပြီး `match` ဖြစ်တဲ့ records တွေကိုသာ join ဖြစ်စေပါတယ်။ **condition** က match မဖြစ်ဘူးဆိုရင် records မထွက်တဲ့အခါမျိုးလည်းရှိတတ်ပါတယ်။
 *Image Credit : W3Schools*
ဥပမာ `students`table နဲ့ `student_details` table ကို **JOIN** ပြီးတော့ data တွေကိုဆွဲထုတ်ပါမယ်။ သို့ပေမယ့် table နှစ်ခုလုံးမှာ **match** ဖြစ်တဲ့ results ကိုသာယူမယ်ဆိုရင်အောက်ကလိုမျိုးရေးနိုင်ပါတယ်။
```
SELECT students.student_id, students.name, student_details.address FROM students INNER JOIN student_details ON students.student_id = student_details.student_id;
```
`student_details` မှာက `student_id` 1 to 5 အထိသာရှိတဲ့အတွက် table နှစ်ခုလုံးမှာ match ဖြစ်တဲ့ condition ဟာ student\_id 1 to 5 ဖြစ်တဲ့ records ငါးကြောင်းသာဖြစ်ပါတယ်။ `students`table မှာရှိတဲ့ `student_id` 6,7,8 ဟာ `student_details` ထဲမှာမရှိတဲ့အတွက်ပါလာမှာမဟုတ်ပါဘူး။

## Left Join
Left Join ကတော့ဘယ်ဘက်ခြမ်းက records အားလုံးနဲ့ ညာဘက်ခြမ်းက **match** ဖြစ်တဲ့ records တွေကိုဆွဲပေးပါတယ်၊ သို့ပေမယ့်ဘယ်ဘက်ခြမ်းက records တွေကအားလုံးပါတာဖြစ်တဲ့အတွက်ညာဘက်ခြမ်းက **match** မဖြစ်တဲ့ records တွေရဲ့ column တန်ဖိုးနေရာမှာတော့ `NULL` values တွေပါလာမှာဖြစ်ပါတယ်။
 *Image Credit : W3Schools*
```
SELECT students.student_id, students.name, student_details.address FROM students LEFT JOIN student_details ON students.student_id = student_details.student_id;
```
ဒီ query မှာဆို LEFT JOIN သုံးထားပြီးတော့ `Left` side table က `stuents` ဖြစ်မယ်။ `Right` side table က `student_details` ဖြစ်မယ်။ `student_details` table မှာမရှိတဲ့ `students` table က records တွေက `address` column မှာ NULL value တွေဖြစ်နေမှာဖြစ်ပါတယ်။ အောက်ကပုံနဲ့တွဲကြည့်ရင်ပိုနားလည်ပါလိမ့်မယ်။

## Right Join
Right join ကတော့ Left join နဲ့သဘောတရားချင်းတူတူပါပဲကိုမှ `right` table က records ကအကုန်ပါမယ်၊ `left` ဘက်က **match** မဖြစ်တဲ့ records တွေကတော့ `students`table က column တွေနေရာမှာ NULL value တွေဖြစ်သွားပါမယ်။
 *Image Credit : W3Schools*
```
SELECT students.student_id, students.name, student_details.address FROM students RIGHT JOIN student_details ON students.student_id = student_details.student_id;
```
Result ပုံနဲ့တွဲကြည့်ရင်ပိုနားလည်သွားပါမယ်။ လက်ရှိ table ထဲမှာတော့ right table `student_details` ထဲက records တွေအားလုံး left table `students` မှာ match records ရှိနေတဲ့အတွက် NULL values မတွေ့နိုင်ပါဘူး။ `student_details` ထဲမှာ `students` table ထဲမှာမရှိတဲ့ `student_id` တစ်ခုခုနဲ့ records ဖန်တီးပြီးပြန် run ကြည့်လိုက်မယ်ဆိုမတူတဲ့ result တစ်မျိုးရပါလိမ့်မယ်၊ စမ်းပြီးလုပ်ကြည့်ပါ။

## Full Join
Full join ကတော့အရှင်းဆုံးပြောရရင် Left join နဲ့ Right Join ကိုပေါင်းထားတဲ့သဘောပါပဲ။ အပြန်အလှန် **match** မဖြစ်တဲ့ records တွေမှာတော့ NULL values တွေဝင်သွားပါမယ်။
 *Image Credit : W3Schools*
ကျနော်တို့အခုသုံးနေတဲ့ MySQL DBMS မှာ `FULL JOIN` ဆိုတဲ့ keyword မရှိပါဘူး။ အဲ့အတွက်ကြောင့် `UNION` ဆိုတဲ့ keyword သုံးပြီးတော့ left နဲ့ right ကိုပေါင်းလိုက်ပါတယ်။ အောက်ကနမူနာ query ကို run ကြည့်နိုင်ပါတယ်။
```
SELECT students.student_id, students.name, student_details.address
FROM students
LEFT JOIN student_details ON students.student_id = student_details.student_id
UNION
SELECT students.student_id, students.name, student_details.address
FROM students
RIGHT JOIN student_details ON students.student_id = student_details.student_id
WHERE students.student_id IS NULL;
--- WHERE case ကမထည့်လည်းရပါတယ်။ ကျနော်ရေးတာပိုသွားတာပါ။
```

Full Join တွေက records တွေကိုဘယ်ညာအကုန်ပြန်ထုတ်ပေးတဲ့အတွက်ပုံမှန်ထက်ပိုပြီးနှေးပါတယ်၊ data တွေမြောက်မြားစွာသိမ်းထားတဲ့ table တွေကို `full join` လုပ်တော့မယ်ဆို **efficiency** သိသိသာသာကျစေတဲ့အတွက် ဒီတစ်ချက်ကိုတော့သတိပြုထားသင့်ပါတယ်။
Recap လုပ်ရမယ်ဆို Inner join ဆိုတာ match ဖြစ်တဲ့ records သီးသန့်။ Left join ဆိုတာ left ကအကုန်၊ right က match records သီးသန့်။ Right join ဆိုတာ right ကအကုန်၊ left က match records သီးသန့်။ Full join ဆိုတာ filter မရှိဘဲ ဘယ်ညာအကုန်။
များသောအားဖြင့် development လုပ်ပြီဆို database ထဲမှာ table relations တွေများစွာပါတတ်ပါတယ်။ Join တွေကိုနားလည်ထားမှသာမိမိလိုသလို table တွေကိုချိတ်ဆက်ပြီး data တွေကို efficiency ကောင်းကောင်းနဲ့ထုတ်သွားနိုင်မှာဖြစ်ပါတယ်။ ဒီအပိုင်းမှာ section တစ်ခုစီကို query တစ်ကြောင်းပဲရေးပြထားပါတယ်၊ ရှုပ်သွားမှာစိုးလို့ပါ။ နောက်အပိုင်းမှာ relationship type တွေအကြောင်းထပ်ရှင်းပြရင်း join queries တွေဆက်လေ့လာသွားကြပါမယ်။
# Relationship in queries
အရှေ့အပိုင်းမှာရေးခဲ့တဲ့ one to one, one to many, many to many relationship တွေအကြောင်းကိုအခုအပိုင်းမှာလက်တွေ့ query တွေရေးကြည့်ပြီးထပ်လေ့လာသွားကြပါမယ်။ INNER နဲ့ LEFT JOIN တွေကိုအဓိကထားပြီးသုံးသွားမှာဖြစ်လို့ဘယ်လိုပုံစံမျိုးလိုချင်တဲ့အခါ ဘယ် JOIN ကိုသုံးနိုင်တယ်ဆိုတာမျိုးကိုပါတစ်ပါတည်းမှတ်သွားစေချင်ပါတယ်။
## One to one
Query တွေစမ်းပြီးရေးကြည့်ဖို့အတွက် `students` နဲ့ `student_details`table နှစ်လုံးကိုအသုံးပြုပါမယ်။ `student` တစ်ယောက်မှာ detail info တစ်ခုသာရှိနိုင်ပါတယ်။ (One to one relationship type)
`students` table ထဲမှာရှိတဲ့ records တွေကိုသက်ဆိုင်ရာ `student_details` records တွေနဲ့အတူ JOIN လုပ်ပြီးဆွဲထုတ်ကြည့်ပါမယ်
```
SELECT students.student_id, students.name, student_details.address FROM students JOIN student_details ON students.student_id = student_details.student_id;
```

***
`student_details` ဘက်မှာ records မရှိတဲ့ `students` တွေကိုထုတ်ကြည့်ပါမယ်။
```
SELECT students.student_id, students.name FROM students LEFT JOIN student_details ON students.student_id = student_details.student_id WHERE student_details.student_id IS NULL;
```

***
`students` တစ်ယောက်တည်းကိုပဲသူ့ရဲ့ details record နဲ့အတူဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT students.name, student_details.address FROM students LEFT JOIN student_details ON students.student_id = student_details.student_id WHERE students.student_id = 2;
```

***
## One-to-Many Relationship:
Relationship အပိုင်းမှာတုန်းက create လုပ်ခဲ့တဲ့ `authors` နဲ့ `books` table ကိုအသုံးပြုပါမယ်။ `authors` တစ်ယောက်မှာရေးခဲ့တဲ့ `books` တွေအများကြီးရှိနိုင်တယ်ဆိုတဲ့ **one to many** relationship ပုံစံဖြစ်ပါတယ်။ Table အလွတ်တွေဖြစ်တဲ့အတွက် data တွေအရင်ထည့်ပါမယ်။
```
-- Insert authors
INSERT INTO authors (author_id, name) VALUES
(1, 'Jane Doe'),
(2, 'John Smith'),
(3, 'Alice Johnson');
```
```
-- Insert books
INSERT INTO books (book_id, title, author_id) VALUES
(101, 'The Art of SQL', 1),
(102, 'Database Design Mastery', 1),
(103, 'Query Optimization Techniques', 2),
(104, 'Introduction to Relational Databases', 3);
```
 
***
စာအုပ်တွေကိုဆွဲထုတ်ရင်းတစ်ပါတည်းရေးခဲ့တဲ့ author တွေကိုပါထုတ်ကြည့်ပါမယ်။
```
SELECT books.book_id, books.title, authors.name AS author_name FROM books JOIN authors ON books.author_id = authors.author_id;
```

***
စာအုပ်မရေးဖူးတဲ့ author record ကိုဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT authors.author_id, authors.name FROM authors LEFT JOIN books ON authors.author_id = books.author_id WHERE books.book_id IS NULL;
```

***
လောလောဆယ်သွင်းထားတဲ့ data အရ စာအုပ်မရေးထားတဲ့ author record မရှိတဲ့အတွက်ကြောင့် author record အသစ်တစ်ကြောင်းထည့်ကြည့်ပြီး query ကိုပြန် run ကြည့်ပါမယ်။

book record မရှိတဲ့ author တစ်ယောက်ဖန်တီးလိုက်ပါပြီ။ Query ကိုပြန် run ကြည့်မယ်ဆို book record reference မရှိတဲ့ author record ကိုမြင်ရမှာဖြစ်ပါတယ်။
## Many-to-Many Relationship:
`students` တစ်ယောက်မှာ `courses` တွေအများကြီးရှိနိုင်သလို `courses` တစ်ခုမှာလည်း `students` အများကြီးရှိနေနိုင်တဲ့ many to many relationship type ဖြစ်ပါတယ်။ Table အလွတ်တွေဖြစ်တဲ့အတွက်ထုံးစံအတိုင်း data တွေအရင်ထည့်ပါမယ်။
```
-- Insert courses
INSERT INTO courses (course_id, course_name) VALUES
(201, 'Database Fundamentals'),
(202, 'Advanced SQL Queries'),
(203, 'Data Modeling and Design'),
(204, 'Database Administration');
```

***
```
-- Insert student courses
INSERT INTO student_courses (student_course_id, student_id, course_id) VALUES
(1, 1, 201),
(2, 1, 202),
(3, 2, 202),
(4, 2, 203),
(5, 3, 201),
(6, 3, 204);
```

***
`student_id` 1 ဖြစ်တဲ့ကျောင်းသားကဘယ်လို `courses` တွေယူထားလဲဆိုတာဆွဲကြည့်ရအောင်။ Many to many relation ဖြစ်တဲ့ဒီနေရာမှာ junction table တစ်ခုခံထားတဲ့အတွက် JOIN ကနှစ်ခါဖြစ်သွားတာကိုသတိချပ်ထားရပါမယ်။
```
SELECT students.name, courses.course_name FROM students JOIN student_courses ON students.student_id = student_courses.student_id JOIN courses ON student_courses.course_id = courses.course_id WHERE students.student_id = 1;
```

***
`course_id` 201 မှာတက်ရောက်နေတဲ့ `students` တွေကိုလည်းထုတ်ကြည့်နိုင်ပါတယ်။
```
SELECT courses.course_name, students.name FROM courses JOIN student_courses ON courses.course_id = student_courses.course_id JOIN students ON student_courses.student_id = students.student_id WHERE courses.course_id = 201;
```

***
`students` ရော `courses` တွေရောအားလုံးကိုဆွဲထုတ်ကြည့်ပါမယ်။ `courses` တွေတက်ရောက်ထားခြင်းမရှိတဲ့ကျောင်းသားတွေတော့ `COALESCE` ဆိုတဲ့ function ကိုသုံးပြီးတော့ `course_name` နေရာမှာ `No Course`ဆိုတဲ့စာသားတစ်ခုအစားထိုးထည့်ပေးလိုက်ပါမယ်။
```
SELECT students.name, COALESCE(courses.course_name, 'No Course') AS course_name FROM students LEFT JOIN student_courses ON students.student_id = student_courses.student_id LEFT JOIN courses ON student_courses.course_id = courses.course_id;
```

***
ဒီအပိုင်းထိရောက်လာပီဆိုရင် query တွေနည်းနည်းအဆင့်မြင့်လာတာနဲ့အတူသူတို့ရဲ့ complexity ရှုပ်ထွေးမှုအပိုင်းလေးတွေကိုပါအနည်းငယ်ခံစားလာရမှာဖြစ်ပါတယ်။ သို့ပေမယ့် အရှေ့နှစ်ပိုင်းမှာရေးခဲ့တဲ့ relationship types , joins တွေအကြောင်းကိုသေချာလိုက်လုပ်ထားမယ်ဆို ဒီအပိုင်းကိုလည်းလိုက်နိုင်မယ်လို့ထင်ပါတယ်။ စာသိပ်မလိုက်နိုင်ဘူးဆို relationship နဲ့ join အပိုင်းကို revision ပြန်လုပ်ပြီးပြန်ဖတ်ပါလို့တိုက်တွန်းချင်ပါတယ်။
# Optimizations and controls
# Indexing
အရင်ဆုံး Indexing ဆိုတာဘာအတွက်လိုတာလဲနဲ့ဘယ်လိုအလုပ်လုပ်တယ်ဆိုတာကို theory introduction လုပ်ပေးပါရစေ။ ပြီးရင်လက်တွေ့ query run ကြည့်ပြီးကွဲပြားချက်ကိုဆန်းစစ်ကြည့်ပါမယ်။
SELECT \* FROM users WHERE name = ‘John’
Database ထဲမှာ ဒီလို query တစ်ကြောင်း run လိုက်တဲ့အချိန်မှာ users table ထဲက name column မှာ John ဆိုတဲ့ value ရှိတဲ့ records တွေပြန်ပေးပါတယ်။ ဒီလိုပြန်ပေးဖို့အတွက် users table ထဲမှာရှိတဲ့ row အားလုံးကို query ကလိုက်ကြည့်ရပါတယ်၊ ဒါကို Full table scan, table တစ်ခုလုံးကိုလိုက်ရှာရတယ်လို့လည်းဆိုပါတယ်။
Index ဆိုတာကတော့ Full table scan, table တစ်ခုလုံးကို scan/lookup လုပ်စရာမလိုတော့ဘဲနဲ့ လိုအပ်တဲ့ scan operation ကိုသာလုပ်ပြီး လိုချင်တဲ့ results တွေကိုရအောင် လုပ်ပေးနိုင်တဲ့ data structure တစ်ခုဖြစ်ပါတယ်။ တစ်နည်းအားဖြင့် query efficiency (read) ကိုမြှင့်ပေးနိုင်တဲ့ အရာတစ်ခုလို့ဆိုနိုင်ပါတယ်။
ပုံမှန်အားဖြင့် data တွေသိမ်းထားတဲ့ table တွေက order စီထားခြင်းမရှိပါဘူး၊ ဒီအတွက်ကြောင့်လည်း condition တစ်ခုကို lookup လုပ်တဲ့အချိန်မှာ table ထဲမှာရှိတဲ့ record အားလုံးကိုဖတ်ရတယ်၊ Linear lookup ပုံစံမျိုးအလုပ်လုပ်ရပါတယ်။ data ပမာဏနည်းသေးတဲ့အချိန်မှာ အဆင်ပြေနေသေးမယ့် data ပမာဏများလာတဲ့အချိန်မှာတော့ query execution time ကပိုပြီးကြာလာနိုင်ပါတယ်၊ ဒါမှမဟုတ် table တစ်ခုနဲ့တစ်ခု Join ပြီး lookup လုပ်တဲ့အချိန်တွေမှာလည်း နှစ်ဆလောက်ပိုပြီးကြာသွားနိုင်ပါတယ်။
အလွယ်ကူဆုံးဥပမာတစ်ခုပေးရရင် အကယ်လို့သိမ်းထားတဲ့ data တွေသာ order အစီအစဉ်တကျစီထားနိုင်မယ်ဆို အပေါ်က John ဆိုတဲ့ value ကိုရှာတဲ့အချိန်မှာ ပုံမှန်အတိုင်း full table scan လုပ်ရပေမယ့် first alphabet က J ကိုကျော်သွားတဲ့အချိန်မှာ scan ထပ်ပြီးလုပ်စရာမလိုတော့တဲ့အတွက် scan လုပ်ရမယ့် operation ကို ပမာဏတစ်ခုအထိ လျော့ချနိုင်သွားမှာဖြစ်ပါတယ် (This’s just a metaphor)။
ဒါပေမယ့်တစ်ကယ်တမ်းမှာတော့ table တွေက order စီထားခြင်းမရှိဘူး၊ ကျနော်တို့ရှာချင်တဲ့ query condition တွေကလည်း dynamic ဖြစ်တဲ့အတွက် scan operation မလုပ်ခင်မှာ table column တွေကိုလည်းအဲ့အတိုင်းလိုက်ပြောင်းပြီး order လိုက်စီပေးဖို့မလွယ်ကူပါဘူး။ ဒီနေရာမှာ index ဆိုတဲ့အရာကို သုံးနိုင်ပါတယ်။ Index က ဘာလုပ်ပေးလဲဆိုတော့ data structure တစ်ခုဖန်တီးပေးလိုက်ပါတယ်၊ များသောအားဖြင့် Binary Tree structure (တစ်ခြားသော structure တွေလည်းဖြစ်နိုင်ပါတယ်)။ B-Tree အကြောင်းမသိဘူးဆိုရင် အရင်ရှာဖတ်ကြည့်ဖို့တိုက်တွန်းပါတယ်။ အဓိကရည်ရွယ်ချက်ကတော့ sorting/order လုပ်ထားတဲ့ structure တစ်ခုရလာဖို့ရယ်၊ searching/scanning quality ကိုလည်းအများကြီးကောင်းမွန်သွားစေမှာဖြစ်ပါတယ်။
Index တစ်ခု create လုပ်ပြီဆိုရင်ဘယ် column ကို index ထားမလဲဆိုတာ ပြောပေးရပါတယ်။ ဥပမာကိုယ်က name ဆိုတဲ့ column ကိုပဲ index လုပ်မယ်ဆိုရင် table ထဲမှာရှိတဲ့ name မဟုတ်တဲ့တစ်ခြားသော column တွေကတော့ index ဖြစ်မှာမဟုတ်ပါဘူး။ name ဆိုတဲ့ column အတွက်ပဲ index ဖန်တီးပေးသွားမှာဖြစ်ပါတယ်။
Index ဘယ်လိုဖန်တီးသွားလဲဆိုတော့ index လုပ်ချင်တဲ့ column ကို key အဖြစ်နဲ့ value နေရာမှာ table ထဲမှာရှိတဲ့ record ကိုဆီကိုသွားနိုင်မယ့် reference pointer တစ်ခုသိမ်းထားလိုက်ပါတယ်။ ဆိုတော့ Index structure ထဲမှာ key က index လုပ်ထားတဲ့ column, value နေရာမှာ record reference pointer. Structure ကလည်း sorting စီထားပြီးသားဖြစ်မယ်။ query condition တစ်ခု run လိုက်ပြီဆို table ကိုသွားပြီး full scan မလုပ်တော့ဘဲ ခုနက index structure ထဲမှာပဲ သုံးထားတဲ့ structure အတိုင်း lookup လုပ်မယ် (လက်ရှိမှာတော့ B-tree) ၊ key ရလာပြီဆို reference pointer ကနေမှတစ်ဆင့် တစ်ကယ့် record ကိုသွားပြီးယူလိုက်ရုံပဲ၊ ဒါကြောင့်မို့လို့ lookup လုပ်တဲ့နေရာမှာ linear scanning မဟုတ်တော့ဘဲနဲ့ သုံးထားတဲ့ structure အတိုင်း efficiency ကောင်းကောင်းနဲ့ lookup လုပ်သွားနိုင်မှာဖြစ်ပါတယ်။
ဒါပေမယ့်ကိုယ့်ဘက်ကပေးရမယ့် cost ကလည်းရှိတယ်။ Index တွေအတွက် space ပြန်ပေးရတယ်၊ key , value ပုံစံနဲ့ sorted structure တစ်ခုဖန်တီးရတာကိုး။ နောက်တစ်ခုက lookup/read operation တွေမှာ efficiency ကောင်းပေမယ့် row အသစ်တစ်ခု insert လုပ်တဲ့ operation မှာ index ထောက်ထားတဲ့အတွက် index ပါဖန်တီးပေးဖို့လိုတဲ့အတွက်ကြောင့် ပုံမှန်ထက်တော့ ပိုနှေးသွားမှာဖြစ်ပါတယ်။ update, delete တွေမှာလည်းသဘောတရားကအတူတူပါပဲ။ ဒီလိုပဲ တစ်ခုလိုချင် တစ်ခုပြန်ပေးရတဲ့ trade-off သဘောတရားကတော့ အမြဲရှိတတ်ပါတယ်။
Theory ကတော့ဒီလောက်ဆိုလုံလောက်ပြီလို့ထင်ပါတယ်၊ လက်တွေ့စမ်းပြီးလုပ်ကြည့်ပါမယ်။
`employees` ဆိုတဲ့ table တစ်လုံးဆောက်လိုက်ပါမယ်။ အဆင်ပြေတဲ့ database ကိုအသုံးပြုနိုင်ပါတယ်။
```
CREATE TABLE employees (
employee_id INT PRIMARY KEY,
name VARCHAR(50),
department_id INT
);
```

***
ပြီးရင် data row 100,000 ကို program ရေးပြီးထည့်လိုက်ပါမယ်။ လက်ရှိဒီ program ကိုနားလည်စရာမလိုသေးပါဘူး၊ data ထည့်ပြီး test လုပ်ကြည့်ဖို့အတွက်လောက်ပါပဲ။ ပါဝင်တဲ့ keyword တစ်ခုခြင်းဆီကို မိမိဘာသာ research လုပ်ကြည့်ပြီး program ကိုနားလည်အောင်ကြိုးစားကြည့်လို့လည်းရပါတယ်။
```
DELIMITER $$
CREATE PROCEDURE generate_sample_data()
BEGIN
DECLARE i INT DEFAULT 1;
WHILE i <= 100000 DO
INSERT INTO employees (employee_id, name, department_id)
VALUES (i, CONCAT('Employee', i), FLOOR(RAND() * 3) + 1);
SET i = i + 1;
END WHILE;
END $$
DELIMITER ;
CALL generate_sample_data();
```
> Row 100,000 ဖြစ်တဲ့အတွက် program run တာပြီးအောင်အနည်းငယ်တော့စောင့်ရပါမယ်။

***
`select count(*)` နဲ့အောက်ပါအတိုင်း row count ကိုစစ်ကြည့်လို့ရပါတယ်။ 
***
အရင်ဆုံး query performance ကိုစစ်နိုင်ဖို့အတွက် profile ကို on ထားလိုက်ပါမယ်။ `SHOW PROFILES` နဲ့ပြန်စစ်ကြည့်မယ်ဆို run ခဲ့တဲ့ query list ရဲ့ Profiles တွေကိုတွေ့နိုင်ပါတယ်။

***
Index create မလုပ်ခင်မှာ query တစ်ကြောင်းအရင် run ကြည့်ပါမယ်။ ရိုးရိုးရှင်းရှင်း employees table ထဲက လိုချင်တဲ့ name ကိုလှမ်းဆွဲထုတ်ကြည့်ပါမယ်။
```
SELECT * FROM employees WHERE name = “Employee500”
```
ပြီးတာနဲ့ `SHOW PROFILES` နဲ့ပါတစ်ခါတည်းစစ်ကြည့်လိုက်မယ်ဆို QUERY ID, Duration တွေကိုတွေ့နိုင်ပါတယ်။

***
နောက်တစ်ဆင့်အနေနဲ့ `employees` table ထဲက name အပေါ်မှာ `index` တစ်ခုဖန်တီးသွားပါမယ်။ ပြီးရင် ခုနက run ခဲ့တဲ့ query ကို ပြန် run ကြည့်ပါမယ်။ index ကြောင့် query performance ကတက်လာသင့်ပါတယ်။
```
CREATE INDEX idx_employee_name ON employees(name);
```

***
ဒီ query ကိုပြန် run ကြည့်ပြီး `SHOW PROFILES` နဲ့စစ်ကြည့်ပါမယ်။
```
SELECT * FROM employees WHERE name = “Employee500”
```

***
Duration မှာ index တည်ဆောက်ခဲ့ပြီးမှ run ခဲ့တဲ့ query ကသိသိသာသာနည်းသွားတာကိုကြည့်ခြင်းအားဖြင့် query performance တက်လာကိုမြင်နိုင်ပါတယ်။ Row 100,000 နဲ့ simple WHERE query ကိုပဲဥပမာပြထားပေမယ့် real world မှာဒီထက်ပိုများတဲ့ data တွေနဲ့ပိုရှုပ်ထွေးတဲ့ query တွေမှာဆိုသိသိသာသာခြားနားသွားမှာဖြစ်ပါတယ်။
နိဂုံးချုပ်ရမယ်ဆို Indexing ဟာ query performance နဲ့ overall efficiency ကိုသိသာစွာမြှင့်တင်ပေးနိုင်ပါတယ်။ သို့ပေမယ့်အပေါ်မှာပြောပြခဲ့တဲ့အတိုင်း trade off တစ်ချို့ရှိပါတယ်။ over-indexing မဖြစ်အောင် မကြာခဏအသုံးပြုလေ့ရှိတဲ့ columns တွေကိုပဲ index ထည့်မယ်၊ ရေရှည်အားဖြင့် index တွေကို monitor & maintain လုပ်ခြင်းအားဖြင့်သင့်လျှော်စွာအသုံးပြုသင့်ကြောင်းကိုလည်းသတိချပ်ထားသင့်ပါတယ်။
# Triggers
SQL ရဲ့ data manipulation action (INSERT, UPDATE, DELETE) ပေါ်မှာမူတည်ပြီး automatic query တွေ ထပ်ပြီး run ချင်တဲ့နေရာမျိုးမှာ Trigger တွေကိုအသုံးပြုနိုင်ပါတယ်။ ဥပမာ `student` ဆိုတဲ့ table ထဲကို `INSERT` ထည့်တဲ့အချိန်မှာ `student_logs` table ထဲကို data ထပ်သွင်းနိုင်ဖို့ trigger ကိုအသုံးပြုပြီး define လုပ်ထားနိုင်ပါတယ်။
Trigger နှစ်မျိုးရှိပါတယ်။
### Before Triggers
* Before ကတော့ မူလ query event execute မလုပ်ခင်မှာ triggering လုပ်ပါတယ်။
* များသောအားဖြင့် DB ထဲမှာပြောင်းလဲမှုတွေမလုပ်ခင် validation လုပ်ဖို့အတွက်အသုံးပြုပါတယ်။
### After Triggers
* After ကတော့မူလ query event က execute လုပ်ပြီးတော့မှ triggering လုပ်ပါတယ်။
* DB ထဲမှာပြောင်းလဲမှုတွေပြီးမှ trigger လုပ်တဲ့အတွက်များသောအားဖြင့် logging, reporting တို့အတွက်အသုံးပြုပါတယ်။
Schema ကတော့အောက်ပါအတိုင်းဖြစ်ပါတယ်။
```
CREATE TRIGGER trigger_name
BEFORE INSERT ON table_name
FOR EACH ROW
BEGIN
-- Trigger statements
END;
```
နမူနာ query လေးတွေစမ်းလုပ်ကြည့်ပါမယ်။
`products` table ထဲကို data update လုပ်တဲ့အချိန်မှာ `price` column ရဲ့ တန်ဖိုးကို 0 အောက်မရောက်ဖို့ validation check လုပ်ကြည့်ပါမယ်။ Execute မလုပ်ခင်မှာ check လုပ်ချင်တာဖြစ်တဲ့အတွက် `BEFORE` ကိုသုံးနိုင်ပါတယ်။
```
DELIMITER //
CREATE TRIGGER check_price
BEFORE UPDATE ON products
FOR EACH ROW
BEGIN
IF NEW.price < 0 THEN
SIGNAL SQLSTATE '45000' SET MESSAGE_TEXT = 'Price cannot be negative';
END IF;
END; //
DELIMITER ;
```

***
`DELIMITER` ထည့်သုံးရခြင်းကတော့ trigger လို stored procedure တွေမှာ statements တွေတစ်ခုထက်ပိုပါနိုင်ပြီး `;` အများအပြားရှိနိုင်ပြီး syntax error ဖြစ်နိုင်တဲ့အတွက် `DELIMITER` ကိုသုံးပြီးတော့ ယာယီအစားထိုးထားလိုက်ခြင်းဖြစ်ပါတယ်။ DELIMITER အကြောင်းအသေးစိတ်ကိုအောက်ကလင့်ခ်မှာဆက်ဖတ်နိုင်ပါတယ်။
ဆောက်လိုက်တဲ့ trigger ကိုဒီလိုပြန်ကြည့်နိုင်ပါတယ်။
#### Schema
```
SHOW TRIGGERS WHERE `Table` = 'your_table_name';
```
`products` table မှာဆောက်ခဲ့တာဖြစ်တဲ့အတွက်
```
SHOW TRIGGERS WHERE `Table` = 'products';
```
ပြန်စစ်တဲ့အနေနဲ့ `price` column ကို negative value ထည့်ပြီး query တစ်ခု execute လုပ်ကြည့်ပါမယ်။
```
UPDATE products SET price = -100 WHERE product_id = 1;
```

ဆောက်ထားတဲ့ `check_price` trigger ကဝင်လာပြီး `error` ပြပေးသွားတာကိုမြင်ရမှာဖြစ်ပါတယ်။
နောက်ထပ်နမူနာတစ်ခုအနေနဲ့ `employee` table ကိုပြောင်းလဲမှုပြုလုပ်တိုင်းမှာ table နောက်တစ်ခုမှာ `audit` logs တွေသိမ်းထားချင်တယ်ဆိုအောက်ပါအတိုင်း `AFTER` trigger တစ်ခုဖန်တီးထားနိုင်ပါတယ်။ သဘောတရားကိုနားလည်သွားပြီလို့ယူဆတဲ့အတွက် Table နောက်တစ်လုံးအသစ်ထပ်မဆောက်တော့ပါဘူး၊ မိမိဘာသာလေ့ကျင့်တဲ့အနေနဲ့စမ်းလုပ်ကြည့်လို့လည်းရပါတယ်။
* `employee_audit` table အသစ်တစ်လုံးဆောက်မယ်။
* `employees` table ပေါ်မှာအောက်က query နဲ့ trigger တစ်ခုဖန်တီးမယ်။
* `employees` table မှာ `UPDATE` query တစ်ခု run ကြည့်မယ်။
* ဒါဆိုရင် trigger ကအသက်ဝင်သွားပြီး audit table မှာ data အသစ်ထည့်သွားတာကိုမြင်နိုင်မှာဖြစ်ပါတယ်။
```
DELIMITER //
CREATE TRIGGER log_employee_changes
AFTER UPDATE ON employees
FOR EACH ROW
BEGIN
INSERT INTO employee_audit (employee_id, action, timestamp)
VALUES (OLD.employee_id, 'UPDATE', NOW());
END; //
DELIMITER ;
```
ဒီလောက်ဆိုရင် `triggers` တွေအကြောင်းကိုအခြေခံအားဖြင့်နားလည်သွားမယ်လို့ထင်ပါတယ်၊ project domain ပေါ်မူတည်ပြီး trigger တွေဟာ ယခုထက်ပိုပြီး complex ဖြစ်နိုင်ပါတယ်။ များသောအားဖြင့်လက်ရှိအသုံးပြုနေတဲ့ programming language နဲ့ framework တွေမှာ support ရှိတဲ့အတွက် `trigger` တွေသီးသန့်မဖန်တီးဘဲ `application` layer မှာတင် DB transaction `before` & `after` hook တွေနဲ့ develop လုပ်နိုင်ပါတယ်။ သို့ပေမယ့်လည်း `trigger` တွေကိုအသုံးပြုမယ့်အခြေအနေတွေလည်းရှိနေနိုင်သေးပါတယ်။
Trigger တွေသုံးမယ်ဆို
* Performance overhead မဖြစ်အောင်ဂရုစိုက်ပြီး တတ်နိုင်သမျှ lightweight ဖြစ်အောင်ဖန်တီးသင့်ပါတယ်။
* Trigger တွေက ပုံမှန် query တွေထက်အနည်းငယ်ဖတ်ရခက်နိုင်တဲ့အတွက် over complex မဖြစ်အောင်၊ ရေရှည်မှာ maintainability issues တွေမရှိအောင် review လုပ်ထားသင့်ပါတယ်။ သင့်တော်တဲ့ comments တွေနဲ့တစ်ပါတည်း document လုပ်ထားသင့်ပါတယ်။
* Triggers တွေဆောက်ပြီးတာနဲ့ ကိုယ်လိုအပ်သလို trigger ဖြစ်ရဲ့လားဆိုတာကိုလည်း Test သေချာလုပ်ထားသင့်ပါတယ်၊ မဟုတ်ရင် `triggers` တွေကအတော်လေး risk ကြီးပါတယ်။
Conclude လုပ်ရမယ်ဆို `triggers` တွေကိုအသုံးပြုခြင်းဖြင့် DB ဘက်ခြမ်းမှာတင် automation tasks တွေဖန်တီးနိုင်တဲ့အတွက်အလွန်အသုံးဝင်နိုင်သလို best practices တွေမလိုက်နာရင်လည်း database အတွက် risk များတတ်နိုင်တဲ့အတွက်ကြောင့်ဂရုပြုပြီးဖန်တီးသင့်ပါတယ်။
# Transactions
Database ပေါ်ကို execute လုပ်သွားမယ့် operation တစ်ခု သို့ တစ်ခုထပ်ပိုတဲ့ operation sequence set တစ်ခုကို transaction လို့သတ်မှတ်နိုင်ပါတယ်။ Transaction တွေရဲ့ပုံစံက All or Nothing ဖြစ်ပါတယ်။ ဥပမာ TableA ကို Insert operation, TableB ကို Update operation လုပ်မယ့် transaction တစ်ခုရှိတယ်ဆိုပါစို့။ နှစ်ခုလုံးရဲ့ insert & update operation က success ဖြစ်ရမယ်။ Partial success, partial failure state ကိုလက်မခံဘူး၊ All or nothing result ပဲဖြစ်သွားမှာဖြစ်ပါတယ်။ ပိုပြီးနားလည်ရလွယ်အောင် အောက်မှာ query တွေ run ပြပြီး နမူနာတွေထပ်ပေးထားပါတယ်။
Query တွေမ run ခင်မှာ Transactions အကြောင်းရေးပြီဆိုမပါလို့မဖြစ်တဲ့ `ACID` property ကိုအရင်ထည့်ရေးချင်ပါတယ်။ Transaction ရယ်လို့ဖြစ်လာပြီဆို Atomicity, Consistency, Isolation, and Durability ဆိုတဲ့ key characteristic တွေပါဝင်ပါတယ်။
### Atomicity
Transactions တွေက atomic ဖြစ်ပါတယ်။ ပါဝင်တဲ့ operation sequences တွေအားလုံး success ဖြစ်ရင်ဖြစ်၊ partial failure တစ်ခုပါတာနဲ့ အားလုံးဟာ roll back ပြန်ဖြစ်သွားပါမယ်။
### Consistency
Before and after Transactions execution တွေမှာ data တွေကမှန်ကန်စွာကျန်ရှိနေခဲ့ရမယ်၊ partial failure တစ်ခုခုဖြစ်သွားရင် data consistency ကိုထိခိုက်နိုင်ပါတယ်၊ ဆိုတော့ somehow related with above atomicity property.
### Isolation
Transaction တစ်ခုနဲ့တစ်ခုအပေါ်မှာမှီခိုဆက်စပ်ခြင်းရှိမနေဘဲနဲ့ concurrently execution လုပ်နိုင်မယ်။
### Durability
Transaction execution (commit) လုပ်ပြီးသွားတာနဲ့ system failure, power outage တွေရှိသည့်တိုင်အောင် data တွေ persist ဖြစ်နေမယ်။
Geeksforgeeks က ဒီပုံလေးနဲ့ဆိုပိုပြီးမြင်သာသွားမယ်ထင်ပါတယ်။

ACID properties ကိုအတိုချုပ်ရေးထားပေမယ့်အသေးစိတ်ကို ဒီမှာဝင်ဖတ်ကြည့်လို့ရပါတယ်။
## Sample Queries
Transaction query နမူနာလေးတွေစမ်းရေးကြည့်သွားပါမယ်။
Transaction တစ်ခုစဖို့အတွက် `BEGIN` ဆိုတဲ့ keyword ကိုသုံးသွားပါမယ်။
```
BEGIN;
INSERT INTO products VALUES(10, 'Energy Drink', 'Electronics', 20, 50, 'SupplierA');
```
`products` table ထဲကို data တစ်ကြောင်းသွင်းပါမယ်။ ရလဒ်ကိုအောက်ပါအတိုင်းကြည့်နိုင်ပါတယ်။

BEGIN နဲ့ transaction တစ်ခုစထားတာဖြစ်တဲ့အတွက် သွင်းလိုက်တဲ့ record ကို `ROLLBACK` လုပ်ပြီး `undo` ပြန်လုပ်နိုင်ပါတယ်။

ID 10 ပြန်ပျောက်သွားတာကိုမြင်ရပါမယ်။
သွင်းဖို့သေချာသွားပြီဆိုရင်တော့ `COMMIT` ကိုသုံးပြီးတော့ finalize လုပ်လိုက်လို့ရပါပြီ။

UPDATE operation နှစ်ခုပါတဲ့ transaction တစ်ခု run ကြည့်ပါမယ်။
```
BEGIN;
UPDATE products SET price = price + 100 WHERE category = 'Electronics';
UPDATE products SET price = price + 100 WHERE category = 'Clothing';
COMMIT;
```

မ run ခင်က data တွေနဲ့ပြန်ယှဉ်ကြည့်မယ်ဆိုသက်ဆိုင်ရာ category တွေမှာ price 100 ထပ်ပေါင်းသွားတာကိုမြင်ရပါမယ်။
### Transactions with Savepoints
Transaction ကို `SAVEPOINT` တွေသုံးပြီးတော့လည်းအသုံးပြုနိုင်ပါတယ်။ မိမိလိုတဲ့ `SAVEPOINT` ကိုအောက်ပါအတိုင်း `ROLLBACK` လည်းလုပ်နိုင်ပါတယ်။
```
SAVEPOINT before_update;
UPDATE products SET price = price + 100 WHERE category = 'Electronics';
SAVEPOINT before_second_update;
UPDATE products SET price = price + 100 WHERE category = 'Clothing';
-- Rollback to the second savepoint
ROLLBACK TO before_second_update;
COMMIT;
```

ဒီ transaction မှာဆို `before_second_update` အထိပြန် `ROLLBACK` သွားပြီး clothing category အတွက် effect ဖြစ်သွားတော့မှာမဟုတ်ပါဘူး။

## Tips when using transactions
Transactions တွေသုံးတဲ့အချိန်မှာ
* တတ်နိုင်သလောက် simple ဖြစ်နိုင်ရင်ပိုကောင်းပါတယ်။
* Long running transactions တွေဟာ concurrency နဲ့ performance issues ရှိနိုင်တာကိုသတိချပ်ထားရပါမယ်။
* လိုအပ်သလို error handling exceptions တွေလည်းထည့်သုံးသင့်ပါတယ်။
Data integrity နဲ့ consistency ကောင်းဖို့အတွက် Transactions တွေကအရေးပါတဲ့အစိတ်အပိုင်းတစ်ခုဖြစ်ပါတယ်။ ဒီအပိုင်းနဲ့ပတ်သတ်လို့ထပ်လေ့လာစရာအများကြီးကျန်ပါသေးတယ်၊ သို့သော်ဒီနေရာကနေလမ်းစတစ်ခုရသွားဖို့မျှော်လင့်ပါတယ်။
# Normalization
ဒီအပိုင်းကနေစပြီးတော့ကျနော်ထပ်ဖြည့်ချင်တဲ့ content လေးတွေထပ်ဖြည့်သွားပါမယ်။ ပြီးခဲ့တဲ့ relationship, join တွေအပိုင်းပြီးရင်အခြေခံအတွက်လုံလောက်ပြီလို့ပြောလို့ရပါတယ်။ နောက်အပိုင်းတွေကတော့ advance ဖြစ်လာတဲ့အတွက် အခေါ်အဝေါ်လေးတွေကအစဖတ်ရတာနည်းနည်းခက်နိုင်ပါတယ်။ ကျနော်တတ်နိုင်သလောက်တော့နားလည်ရလွယ်အောင်စဉ်းစားပြီးရှင်းပြပေးထားပါတယ်။ ဒီအပိုင်းတွေကိုဖတ်ရင်းနဲ့တစ်ခြားသော online က resources တွေနဲ့လည်းတွဲဖက်ပြီးပိုစဉ်းစားနိုင်ဖို့အကြံပြုပါတယ်ခင်ဗျာ။
Database ထဲမှာ data တွေများလာတဲ့အခါမှာပြန်ထုတ်ယူရတဲ့နေရာမှာကိုယ်လိုချင်တဲ့ data တွေအတိုင်းထပ်အပ်ကျဖို့ဆိုတာခက်ခဲလာနိုင်ပါတယ်။ Normalization ရဲ့အကူအညီနဲ့ဒီလိုအခက်အခဲတွေကိုကျော်လွှားနိုင်ပါတယ်။ Normalization ဟာ data redundancy (data ဆုံးရှုံးမှု) ဖြစ်နိုင်မှုကိုလျော့ချနိုင်ပြီးတော့ data integrity (data စစ်မှန်မှု) ကိုပိုမိုကောင်းမွန်လာနိုင်စေပါတယ်။
ဥပမာအားဖြင့် Normalize မလုပ်ထားတဲ့ data တွေဆို data ဆွဲထုတ်တဲ့အချိန်မှာထပ်နေတဲ့အချိန်မှာထပ်နေတဲ့ data တွေပါလာနိုင်တာမျိုး၊ data ထည့်တဲ့အချိန်မှာ attribute တွေမကိုက်လို့ထည့်မရတာမျိုး၊ ကိုယ်ဖျက်ချင်တာကတစ်မျိုး၊ attributes တွေရောယှက်ပြီးတော့ပျက်သွားတာကတစ်မျိုးတွေဖြစ်တတ်ပါတယ်။
Normalization ဆိုတာတစ်နည်းအားဖြင့် data တွေကို organize ဖြစ်အောင်လုပ်ထားတာပါပဲ။ Database ထဲမှာရှိတဲ့ tables နဲ့ columns တွေကိုသတ်မှတ်ထားတဲ့ constraints (စည်းမျဉ်း) တွေနဲ့ organize လုပ်ထားခြင်းပဲဖြစ်ပါတယ်။
ဒီဆောင်းပါးမှာ Normalization form ၆ ခုကိုရေးပေးသွားမှာဖြစ်ပါတယ်။
## First Normal Form (1NF)
1NF မှာတော့ atomicity ဖြစ်ရမယ်။ တစ်နည်းအားဖြင့် Table တစ်လုံးထဲမှာ multi value attribute တွေမရှိရဘူး၊ column တစ်ခုက multiple value မရှိနေရဘူး။
အောက်က table ကိုနမူနာကြည့်မယ်ဆို `authors` column က value တွေကိုတစ်ခုထက်ပိုပြီးကိုင်ထားပါတယ်။ ဒါဆိုရင် atomicity မဖြစ်တော့ဘူး 1NF ပြောင်းပေးရပါမယ်။
| book\_id | title | authors | genre |
| -------- | -------------- | ------------------------- | ----------- |
| 1 | The Art of SQL | Jane Doe, John Smith | Database |
| 2 | SQL Mastery | Jane Doe, Alice Johnson | Programming |
| 3 | Query Tactics | John Smith, Alice Johnson | Database |
Table ကို `books` နဲ့ `authors`နှစ်ခုအဖြစ်ခွဲပေးလိုက်ပါမယ်။
Books Table:
| book\_id | title | genre |
| -------- | -------------- | ----------- |
| 1 | The Art of SQL | Database |
| 2 | SQL Mastery | Programming |
| 3 | Query Tactics | Database |
Authors Table:
| book\_id | author\_name |
| -------- | ------------- |
| 1 | Jane Doe |
| 1 | John Smith |
| 2 | Jane Doe |
| 2 | Alice Johnson |
| 3 | John Smith |
| 3 | Alice Johnson |
1NF ပြောင်းအပြီးမှာ table တိုင်းရဲ့ column တိုင်းမှာ atomic value တွေပဲရှိနေတော့ပါမယ်။ `authors` table မှာတော့ `books` table ကို reference လုပ်နိုင်အောင် `book_id`ထည့်ပေးထားလိုက်ပါတယ်။ table ကနှစ်လုံးမခွဲလည်းရပါတယ်၊ တစ်လုံးထဲမှာပဲ row တွေပြောင်းထည့်ပြီးသိမ်းခြင်းအားဖြင့်လည်း 1NF ကိုပြေလည်စေပါတယ်။
Candidate Key & Non-prime attribute 2NF ကိုဆက်မသွားခင် candidate key ဆိုတဲ့အရာတစ်ခုကိုမိတ်ဆက်ပေးချင်ပါတယ်။ Candidate key ဆိုတာကတော့ table တစ်လုံးထဲမှာ record တစ်ကြောင်းကို `unique` ဖြစ်တယ်လို့သတ်မှတ်နိုင်တဲ့ တစ်ခု သို့ တစ်ခုထက်ပိုတဲ့ columns တွေကိုဆိုလိုခြင်းဖြစ်ပါတယ်။
 Credit geekforgeek
Non-prime attribute ဆိုတာကတော့ candidate keys မဟုတ်တဲ့ attribute တစ်ခုကိုဆိုလိုခြင်းဖြစ်ပါတယ်။
***
## Second Normal Form (2NF)
2NF ဖြစ်ဖို့အတွက် table က 1NF ဖြစ်ပြီးသားဖြစ်ရပါတယ်။ နောက်တစ်ခုကတော့ partial dependency မဖြစ်ရပါဘူး။ Partial dependency ဆိုတာကိုနားလည်နိုင်ဖို့အောက်ကဥပမာကိုကြည့်နိုင်ပါတယ်။
| student\_id | course\_id | course\_name |
| ----------- | ---------- | ------------------------ |
| 1 | 101 | Database Fundamentals |
| 2 | 102 | Advanced SQL Queries |
| 3 | 103 | Data Modeling and Design |
ဒီ table မှာ `student_id` `course_id` က candidate keys တွေဖြစ်နေပါတယ်။ `course_name` ကတော့ `non-prime` attribute ဖြစ်ပါတယ်။ `course_name` က `course_id`ကိုသွားချိတ် (depend) ဖြစ်နေပါတယ်။ `course_id` ကလည်း candidate key ထဲက proper subset တစ်ခုဖြစ်ပါတယ်။ ဒီလိုမျိုး non-prime attribute က proper subset of candidate key ကိုသွားပြီးမှီခိုနေတယ် (depend) ဖြစ်နေတယ်ဆို partial dependency ဖြစ်နေတယ်လို့ဆိုနိုင်ပါတယ်။
ဒါကို 2NF ပြောင်းဖို့အတွက်အောက်ကလို table တွေခွဲထားနိုင်ပါတယ်။
`course` table
| course\_id | course\_name |
| ---------- | ------------------------ |
| 101 | Database Fundamentals |
| 102 | Advanced SQL Queries |
| 103 | Data Modeling and Design |
`student_course` table
| student\_id | course\_id |
| ----------- | ---------- |
| 1 | 101 |
| 2 | 102 |
| 3 | 103 |
ဒီလိုခွဲထုတ်လိုက်ခြင်းဖြင့် non-prime attribute ဟာသူနဲ့သက်ဆိုင်တဲ့ `primary` key ပေါ်မှာပဲ depend လုပ်သွားမှာဖြစ်ပါတယ်။
Stuents column attribute တွေရှိနေသေးရင်`students` table သက်သက်ထပ်ထုတ်ထားနိုင်ပါတယ်။
***
## Third Normal Form (3NF)
3NF ပြောင်းဖို့အတွက်ဆို table က 2NF ဖြစ်ထားရမယ်။ Transitive dependencies တွေမရှိရဘူး။
* Non-prime attribute တစ်ခုကနောက် non-prime attribute တစ်ခုကိုမှီခိုနေမယ်။
* တစ်နည်းအားဖြင့် A က B ကို depend ဖြစ်မယ်၊ B က primary key ကို depend ဖြစ်မယ်ဆိုရင် A က primary key အပေါ် transitively depend ဖြစ်သွားတယ်လို့ဆိုနိုင်ပါတယ်။
နားလည်လွယ်ဖို့အောက်ကဥပမာကိုကြည့်ရအောင်။
| employee\_id | department\_id | department\_name | manager\_name |
| ------------ | -------------- | ---------------- | ------------- |
| 1 | 101 | IT | Alice Johnson |
| 2 | 102 | HR | Bob Smith |
| 3 | 101 | IT | Alice Johnson |
`manager_name` ဆိုတဲ့ column က `department_id` ကို depend ဖြစ်နေတယ်၊ `department_id` က primary key ဖြစ်တဲ့ `employee_id` ကို depend ဖြစ်နေတဲ့အတွက် transitive dependency ဖြစ်နေတယ်လို့သတ်မှတ်နိုင်ပါတယ်။
3NF ပြောင်းဖို့အတွက် `managers` နဲ့ `departments` table တွေကိုသက်သက်စီခွဲချနိုင်ပါတယ်။
`departments` Table
| department\_id | department\_name |
| -------------- | ---------------- |
| 101 | IT |
| 102 | HR |
`managers` Table
| department\_id | manager\_name |
| -------------- | ------------- |
| 101 | Alice Johnson |
| 102 | Bob Smith |
`employees` Table ကတော့ joint table ဖြစ်သွားပါမယ်။
| employee\_id | department\_id |
| ------------ | -------------- |
| 1 | 101 |
| 2 | 102 |
| 3 | 101 |
ဒါဆိုရင် `manager_name` သည် primary key အပေါ်မှာ transitively မဟုတ်ဘဲ directly depend ဖြစ်သွားပါပြီ။
BCNF ကိုမဆက်ခင် superkey အကြောင်းအရင်ရှင်းပေးချင်ပါသေးတယ်။
Superkey
Superkey ဆိုတာကတော့ table ထဲမှာ row တိုင်းကို unique ဖြစ်နေနိုင်တဲ့ attribute တစ်ခုသို့ တစ်ခုထက်ပိုတဲ့ attribute set လိုက်လည်းဖြစ်နိုင်ပါတယ်။ တစ်နည်းအားဖြင့် superkey ဟာ candidate key တစ်ခု သို့ set of candidate keys လည်းဖြစ်နိုင်သလို တစ်ခြားသော attribute တွေလည်းဖြစ်နိုင်ပါတယ်။
ဥပမာ attribute A, B, C ရှိမယ်၊ {A, B} ဟာ`uniqueness` ကိုထိန်းထားနိုင်မယ်ဆို superkey ဖြစ်နိုင်မယ်။ သို့ပေမယ့် unique ဖြစ်နိုင်တယ်ဆို `superkey` အဖြစ် `C` ကိုလည်းထည့်နိုင်သလို {B, C} ပဲလည်းဖြစ်နိုင်တယ်။ Table ရဲ့ primary key ကို {A, B} လို့သတ်မှတ်ထားတယ်ဆို {A, B} က candidate key အဖြစ်ရှိမယ်၊ superkey လည်းဖြစ်မယ်။ candidate key ကိုယ်တိုင်ကိုက minimal super key အဖြစ်နဲ့တည်ရှိနေတာဖြစ်ပါတယ်။ ဆိုတော့ recap ပြန်လုပ်ရမယ်ဆို
* primary key တိုင်းက candidate key
* candidate key တိုင်းက superkey
* သို့ပေမယ့် superkey တိုင်းကတော့ candidate, primary key မဖြစ်နိုင်ပါဘူး။

Image credit: geekforgeek
***
## Boyce-Codd Normal Form (BCNF)
BCNF form ရောက်ဖို့အတွက်ဆို
* 3rd normal form ကိုရောက်ပြီးသားဖြစ်ရမယ်။
* Dependency တိုင်းမှာ determinant က super key ဖြစ်ရမယ်။
* E.g. A->B dependency မှာ left side က determinant သည် super key ဖြစ်ရမယ်။ အောက်က table တွေနဲ့ဥပမာထပ်ကြည့်ရအောင်။
| Employee\_ID | project\_name | Skill |
| ------------ | ------------- | ------ |
| 101 | projectA | Java |
| 101 | projectB | SQL |
| 102 | projectC | Python |
| 103 | projectA | Go |
employee တစ်ယောက်ဟာ project တစ်ခုထက်ပိုပြီးရှိနိုင်တယ်။ အပေါ်က table မှာ employee\_id နဲ့ project\_id ကိုပေါင်းလိုက်ရင် unique ဖြစ်ပြီးတော့ primary key ဖြစ်သွားပါတယ်၊ skill ကိုလည်းလှမ်းပြီးတော့ဆွဲထုတ်နိုင်ပါတယ်။ dependency ကနှစ်ခုထွက်သွားပါမယ်။
* Employee\_id + project\_id -> skill က dependency တစ်ခုရှိလာမယ်။ Skill တစ်ခုကို project တစ်ခုစီမှာပဲသုံးနေတယ်၊ Project တစ်ခုမှာတော့ skill တစ်ခုထပ်ပိုပြီးရှိနိုင်တဲ့အတွက်
* Skill -> project\_id dependency တစ်ခုရှိပါမယ်။ Skill သည် non-prime attribute ဖြစ်ပါတယ်၊ superkey ဖြစ်မနေပါဘူး။ ဒီအတွက်ကြောင့်အပေါ်က table သည် BCNF form ဖြစ်တယ်လို့ဆိုလို့မရပါဘူး။
အောက်ကအတိုင်းခွဲချလိုက်မယ်ဆိုရင်တော့ BCNF ကိုပြေလည်သွားစေမှာဖြစ်ပါတယ်။
`employee` table
| Employee\_ID | skill\_id |
| ------------ | --------- |
| 101 | 1 |
| 101 | 2 |
| 102 | 3 |
| 103 | 4 |
`skills` table
| skill\_id | skill\_name | project\_name |
| --------- | ----------- | ------------- |
| 1 | Java | ProjectA |
| 2 | SQL | ProjectB |
| 3 | Python | ProjectC |
| 4 | Go | ProjectA |
***
## Fourth Normal Form (4NF)
4NF ကိုပြေလည်စေဖို့အတွက်ဆို table က
* BCNF ဖြစ်ထားရမယ်။
* multi-value dependencies တွေရှိနေလို့မဖြစ်ပါဘူး။ Multi-value dependencies ဖြစ်နိုင်တဲ့အချက်တွေက
* A->B dependency မှာ single A အတွက် B values တွေတစ်ခုထက်မကရှိနေမယ်
* Table ကအနည်းဆုံး column 3 ခုရှိရမယ်
* နှစ်ခုထဲဆို multi-row ခွဲချလိုက်ရုံနဲ့ multi-values မဖြစ်နိုင်တော့ပါဘူး။
* A->B က multi-values dependency ဖြစ်နေတယ်ဆို B->C ကတစ်ခုနဲ့တစ်ခု depend ဖြစ်နေလို့မရပါဘူး။
အောက်က table ကိုနမူနာကြည့်ရအောင်
| customer\_id | product | interest |
| ------------ | ---------- | ----------- |
| 1 | Laptop | Gaming |
| 1 | Smartphone | Programming |
| 2 | laptop | Photography |
| 2 | Smartphone | Gaming |
`customer_id` 1 က product နှစ်ခု၊ interest နှစ်ခုမှာ record တွေရှိနိုင်ပါတယ်။ သေချာစဉ်းစားကြည့်လိုက်မယ်ဆို table structure ကမသေသပ်တာကိုတွေ့ရမယ်၊ product နဲ့ interest က independent ဖြစ်နေတဲ့အတွက် row နှစ်ကြောင်းထပ်ထွက်လာစေနိုင်ပါတယ်။ ဒီလိုမျိုးပေါ့
| customer\_id | product | interest |
| ------------ | ---------- | ----------- |
| 1 | Laptop | Gaming |
| 1 | Smartphone | Programming |
| 1 | Laptop | Programming |
| 1 | Smartphone | Gaming |
Multi-value dependency ကြောင့်မလိုအပ်ဘဲ row တွေကို repeat ဖြစ်စေပါတယ်။
အောက်ကလိုမျိုးခွဲချပြီးတော့ပြေလည်အောင်လုပ်ပေးနိုင်ပါတယ်။
`orders` table
| order\_id | customer\_id | product |
| --------- | ------------ | ---------- |
| 1 | 1 | Laptop |
| 2 | 2 | Smartphone |
`interest` table
| interest\_id | customer\_id | interest |
| ------------ | ------------ | ----------- |
| 1 | 1 | Gaming |
| 2 | 1 | Programming |
| 3 | 2 | Photography |
| 4 | 2 | Gaming |
`customers` table ကသက်သက်နောက် table တစ်လုံးအနေနဲ့ရှိနေပါမယ်။
***
## Fifth Normal Form (5NF): Join Dependencies
5NF ပြေလည်ဖို့အတွက်ဆို table တွေဟာ
* 4th normal form ပြေလည်ပြီးသားဖြစ်ရမယ်။
* Join dependency မရှိရဘူး။
* Joining ကြောင့် data ဆုံးရှုံးမှုမရှိစေရဘူး။
* DB ထဲမှာရှိတဲ့ tables တွေဟာတတ်နိုင်သလောက်မတူညီတဲ့ keys တွေနဲ့ tables အသေးတွေပြန်ခွဲထားနိုင်ရမယ်
* တူညီတဲ့ key နဲ့ခွဲမယ်ဆိုဆုံးတော့မှာမဟုတ်ပါ။
* Table ပြန်ခွဲတဲ့နေရာမှာလည်း business logic ပေါ်မူတည်ပါသေးတယ်။
5th normal form ကို Project join normal form လို့လည်းခေါ်ပါတယ်။
ပိုနားလည်လွယ်အောင်အောက်ကဥပမာတွေကိုဆက်ကြည့်ရအောင်။
| ProjectID | EmployeeID | ProjectName | EmployeeName | HoursWorked |
| --------- | ---------- | ----------- | ------------ | ----------- |
| 101 | 1 | Project A | John Doe | 20 |
| 101 | 2 | Project A | Jane Smith | 15 |
| 102 | 1 | Project B | John Doe | 25 |
| 102 | 3 | Project B | Bob Johnson | 30 |
ဒီ table မှာ project\_id + employee\_id က primary key ဖြစ်မယ်။ သို့ပေမယ့်ဒီ primary key မှာ project\_name data တွေထပ်နေတဲ့အတွက် data redundancy(data ဆုံးရှုံးမှု) ရှိနေပါတယ်။
Table ကို 5th normal form ပြောင်းမယ်ဆိုဒီလိုဖြစ်သွားပါမယ်။
`project` table
| ProjectID | ProjectName |
| --------- | ----------- |
| 101 | Project A |
| 102 | Project B |
`employee` table
| EmployeeID | EmployeeName |
| ---------- | ------------ |
| 1 | John Doe |
| 2 | Jane Smith |
| 3 | Bob Johnson |
`work_hour` table
| ID | ProjectID | EmployeeID | HoursWorked |
| -- | --------- | ---------- | ----------- |
| 1 | 101 | 1 | 20 |
| 2 | 101 | 2 | 15 |
| 3 | 102 | 1 | 25 |
| 4 | 102 | 3 | 30 |
မတူညီတဲ့ keys တွေနဲ့ table အသေးလေးတွေပြန်ခွဲချလိုက်မယ်။ Join လုပ်ကြည့်မယ်ဆိုလည်း data ဆုံးရှုံးမှုမရှိနိုင်တော့တာကိုတွေ့ရပါမယ်။
Normalization ကိုနားလည်သွားမယ်ဆို database တွေကို optimize လုပ်နိုင်လာမယ့်အပြင် data redundancy ဖြစ်နိုင်မှုကိုကျော်ဖြတ်နိုင်မယ်၊ data integrity ပိုကောင်းလာပါလိမ့်မယ်။ ဒါ့အပြင် data dependencies အကြောင်းတွေ ၊ multi-values အကြောင်းတွေကိုပါနားလည်သွားမယ့်အတွက် structure ကျတဲ့ databases တွေကိုတည်ဆောက်နိုင်သွားမှာဖြစ်ပါတယ်။
နိဂုံးချုပ်ရမယ်ဆိုတစ်ကယ်လက်တွေ့ project တွေမလုပ်သေးဘူးတဲ့သူတွေအတွက် normalization ကိုကွက်ကွက်ကွင်းကွင်းနားလည်ဖို့ဆိုတာခက်ပါတယ်။ ဒီ article series လေးကနေအတိုင်းအတာတစ်ခုအ ထိသဘောတရားကိုနားလည်သွားပြီး လက်တွေ့လုပ်တဲ့အခါမှာ memory တစ်ခုအနေနဲ့ပြန်ပြီးအသုံးချနိုင်သွားတယ်၊ ဆက်စပ်နိုင်သွားဖို့မျှော်လင့်ပါတယ်။
# Entity Relationship Diagram
ဒီ article series လေးရဲ့နောက်ဆုံးအပိုင်းအဖြစ် ERD (Entity Relationship Diagram) တစ်ခုတည်ဆောက်တဲ့ပုံစံလေးကိုပြောပြပေးသွားချင်ပါတယ်။
Database တစ်ခုကို design ချတော့မယ်ဆိုရင် ERD ကအရေးပါတဲ့အခန်းကဏ္ဍတစ်ခုအဖြစ်ပါဝင်ပါတယ်။ အကြမ်းဖျင်းရှင်းပြရမယ်ဆိုရင် ERD ဆိုတာ Database တစ်ခုမှာရှိနိုင်တဲ့ entities တွေရဲ့ ဆက်နွယ်မှုပုံစံကိုဖော်ပြဖို့အတွက်အဓိကအသုံးပြုတာဖြစ်ပါတယ်။ အောက်မှာ components တစ်ခုခြင်းဆီအတွက်အသေးစိတ်ထပ်ပြောပြပေးသွားပါမယ်။
### Entities
Entities ဆိုတာကတော့ object တစ်ခု၊ solid concept တစ်ခုလို့သတ်မှတ်နိုင်ပါတယ်။ ဥပမာ E-commerce project တစ်ခုမှာဆိုရှိနိုင်တဲ့ entities တွေက `customer` `products` `orders` အစရှိသဖြင့်ပါဝင်နိုင်ပါတယ်။
### Attributes
Entity ထဲမှာပါတဲ့ properties တွေကို attributes လို့သတ်မှတ်နိုင်ပါတယ်။ ဥပမာ `customer` entity မှာဆို `customer_id, name, email` အစရှိသဖြင့် attributes တွေပါဝင်နိုင်ပါတယ်။
### Relationships
Entities တွေတစ်ခုနှင့်တစ်ခုဆက်နွယ်မှုကိုတော့ relationship လို့ခေါ်ဆိုပြီး relationship ပုံစံတွေကတော့ one-to-one, one-to-many, many-to-many ရှိတတ်ပါတယ်။
### Primary Key
Entity တစ်ခုမှာ unique ဖြစ်နိုင်တဲ့ attribute တစ်ခု သို့ attributes အစုကို Primary key အဖြစ်သတ်မှတ်ပါတယ်။
### Foreign Key
Entities တွေတစ်ခုနှင့်တစ်ခုချိတ်ဆက်ဖို့အတွက် အခြား entity ရဲ့ primary ကို reference လုပ်တဲ့နေရာမှာအသုံးပြုပါတယ်။
***
ERD နဲ့ပတ်သတ်လာလို့ components တစ်ခုခြင်းဆီကိုခွဲထုတ်ပြီးရှင်းပြလိုက်ပေမယ့် အားလုံးကိုရှေ့က articles တွေမှာဖော်ပြဖူးတဲ့အတွက်နားလည်ရလွယ်ကူမယ်လို့ထင်ပါတယ်။
ERD ရဲ့ components တွေကိုသိသွားပြီဆိုတော့တစ်လက်စတည်း ERD တစ်ခုဆွဲကြည့်သွားကြပါမယ်။ ERD တစ်ခုဆွဲတော့မယ်ဆို
1. အရင်ဆုံးပါဝင်တဲ့ entities တွေကိုသတ်မှတ်ဖို့လိုပါတယ်။ အထက်မှာကျနော်ပြောခဲ့တဲ့ e-commerce system တစ်ခုမှာဆို `customers, products, orders, order_details` တွေပါဝင်နိုင်ပါတယ်။ အခြားသော entities တွေလည်းအများကြီးရှိနိုင်ပါသေးတယ်။ ဒါပေမယ့်ဒီအပိုင်းမှာတော့ learning purpose ဖြစ်တဲ့အတွက်လက်ရှိ entities 4 ခုနဲ့ပဲဆွဲကြည့်ကြပါမယ်။
2. Entity တစ်ခုခြင်းဆီအတွက် attributes တွေသတ်မှတ်ကြပါမယ်။ I. `customers`
* customer\_id (Primary Key)
* name
* email
* address
II. `products`
* product\_id (Primary Key)
* name
* price
* stock\_left
III. `orders`
* order\_id (Primary Key)
* order\_date
* customer\_id (Foreign Key)
IV. `order_details`
* order\_detail\_id (Primary Key)
* order\_id (Foreign Key)
* product \_id (Foreign Key)
* quantity
ကျနော်ကတော့ `order` နဲ့ `order_details` table ကိုခွဲပြီးတော့သိမ်းလေ့ရှိပါတယ်။ မိမိအဆင်ပြေသလိုတွဲပြီးသုံးမယ်ဆိုလည်းရပါတယ်။ Data amount များလာရင်တော့ခွဲပြီးသိမ်းတဲ့ပုံစံက `performance` အရရော `structure` အရရောပိုပြီးကောင်းစေပါတယ်။
3. Entities တွေရဲ့ဆက်နွယ်မှုပုံစံတွေကိုသတ်မှတ်ကြပါမယ်။
* Customer တစ်ယောက်ဟာ orders တွေအများကြီးတင်နိုင်တယ်။
* Order တစ်ခုမှာလည်း order\_details တွေထပ်ရှိနိုင်တယ်။
* Product တစ်ခုကလည်း order\_details တွေထဲရှိနိုင်ပါတယ်။
Entities, attributes တွေနဲ့ relationships တွေသတ်မှတ်ပြီးပြီဆိုမိမိနှစ်သက်ရာ drawing tool နဲ့ ERD ကိုဆွဲချနိုင်ပါပြီ။ အောက်ကပုံကတော့ကျနော်ဆွဲထားတဲ့ပုံလေးဖြစ်ပါတယ်။

စနစ်ကျတဲ့ database တစ်လုံးတည်ဆောက်ရန်အတွက် ERD ဆွဲကြည့်ခြင်းဟာအလွန်အရေးပါပါတယ်။ Entities, attributes နဲ့ relationships တွေသတ်မှတ်ခြင်းအားဖြင့် တည်ဆောက်နေတဲ့ application ရဲ့လိုအပ်တဲ့ data structure ကိုထောက်ပံ့ပေးနိုင်မှာလည်းဖြစ်ပါတယ်။
# Conclusion
SQL ကိုလေ့လာချင်တဲ့ beginners တွေအတွက်ရည်ရွယ်ပြီး သင့်တော်မယ့်ကောင်းနိုးရာရာအပိုင်းတွေကိုထုတ်နုတ်ပြီး series လေးလုပ်ထားလိုက်တာဖြစ်ပါတယ်။
series ထဲမှာမပါနိုင်တဲ့တစ်ခြားသောအကြောင်းအရာတွေများစွာရှိသေးအတွက် ဒီနေရာကနေလမ်းစတစ်ခုရပြီး ရှေ့ဆက်လေ့လာသွားဖို့အထောက်အကူပြုနိုင်မယ်လို့ မျှော်လင့်ပါတယ်။
ကျေးဇူးတင်ပါတယ်ခင်ဗျာ။
June 8 2024 22:09:30\
Hlaing Tin Htun